Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS)
Content
研究背景
-
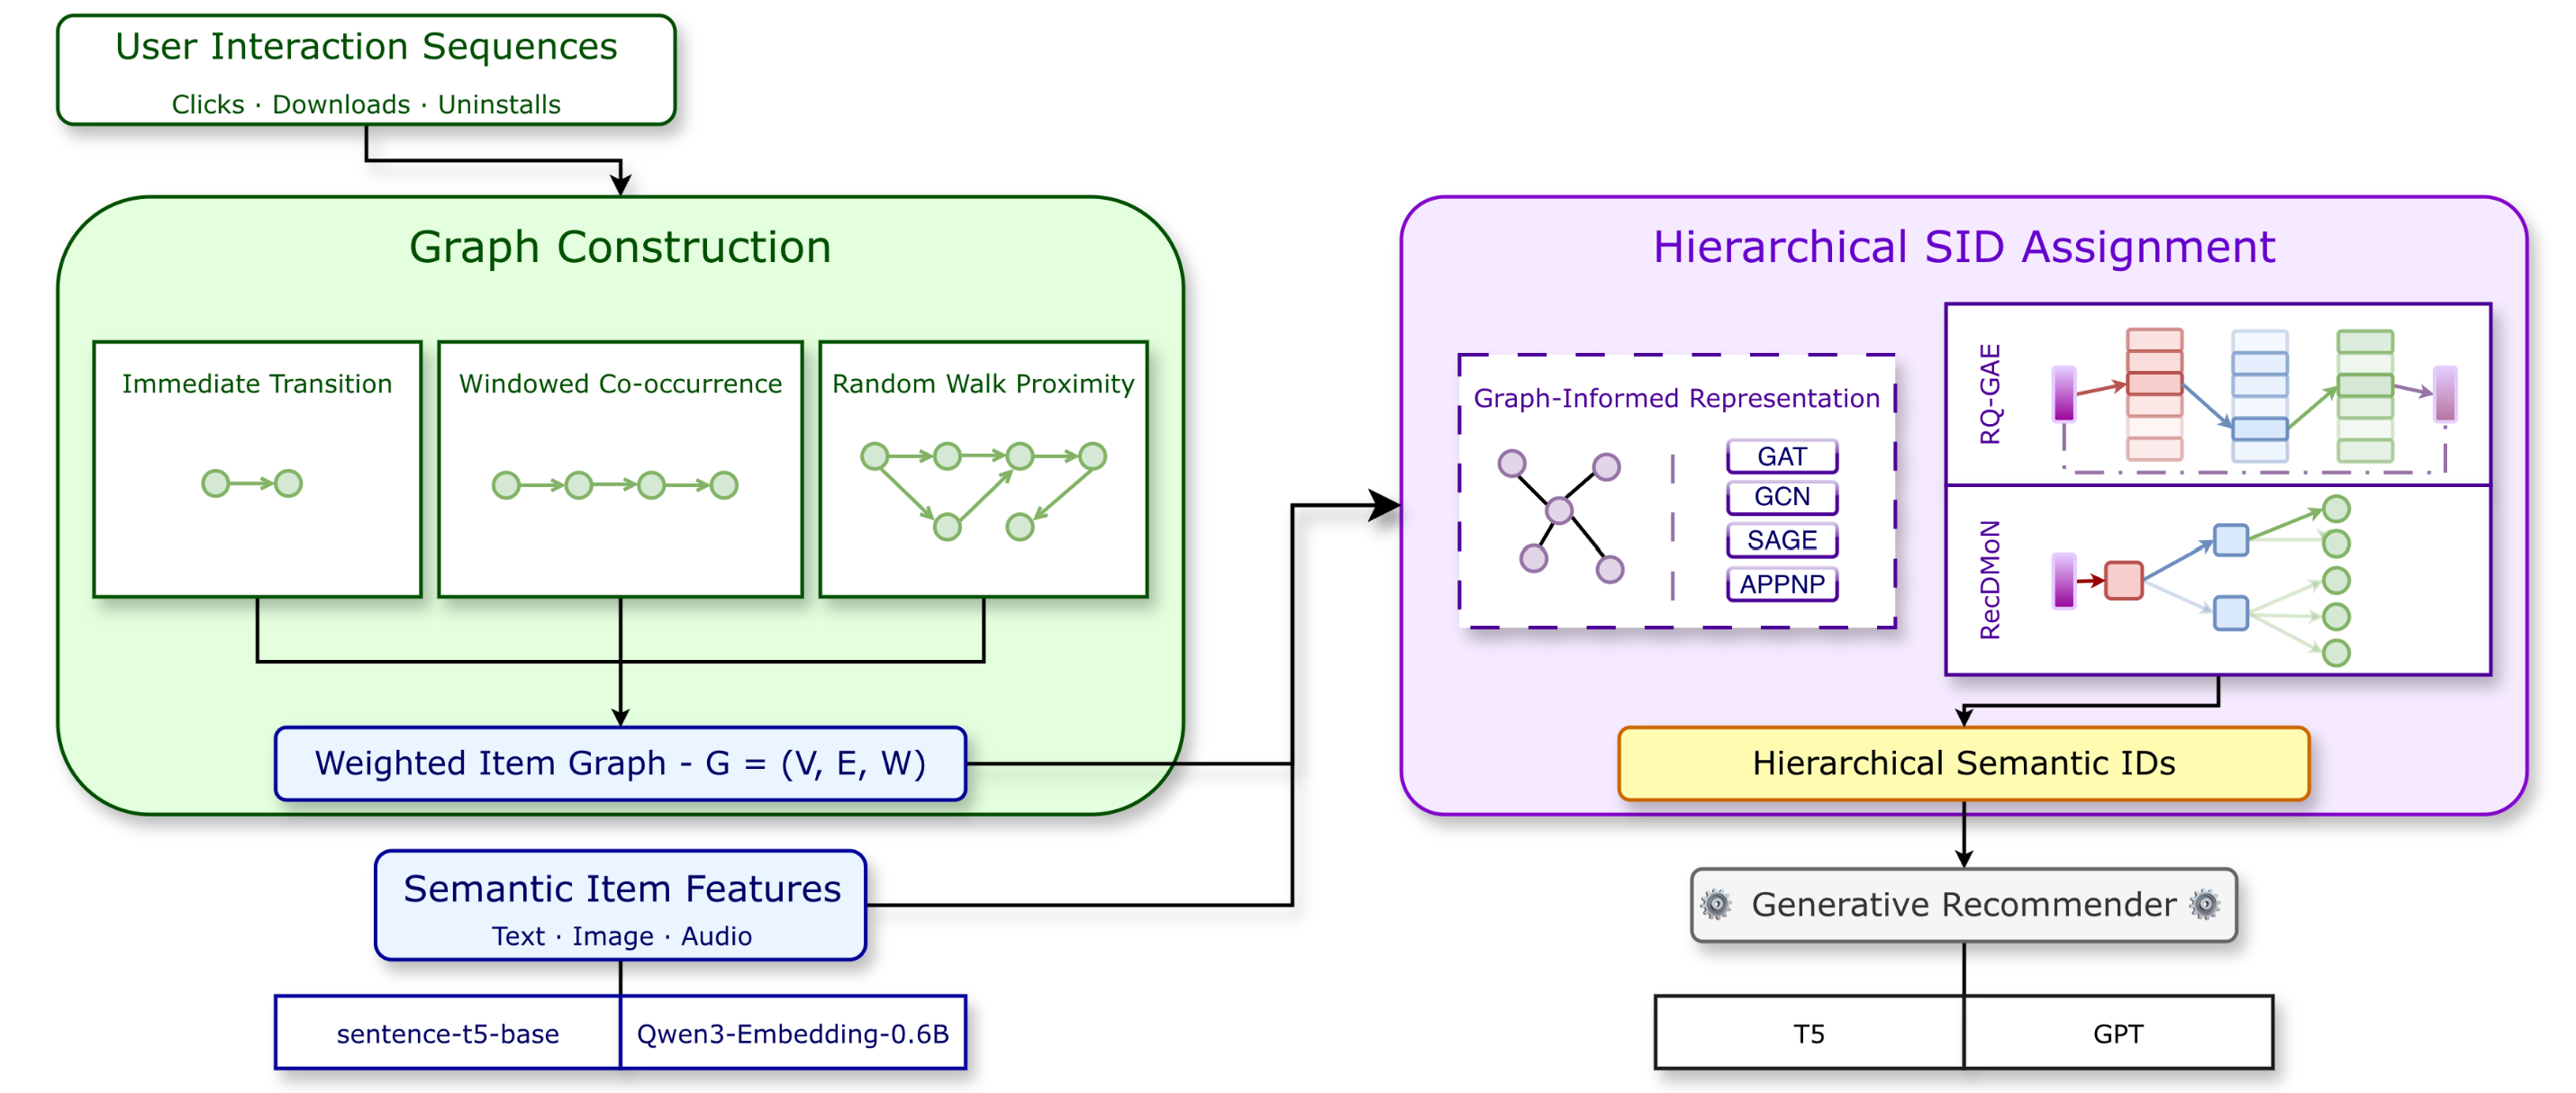
(SID 要组织什么样的相似性) TIGER 用 RQ-VAE 将商品内容表示转为离散编码. 内容相似性与行为相似性各有作用: 描述相近的商品可能面向不同用户, 经常一起消费的商品也可能属于不同类别. GrIS [1] 希望让 SID 的共享前缀同时反映内容语义和协同关系.
-
(从表示量化到层级划分) 作者将 SID 构造理解为逐层划分商品集合: 粗层确定分组, 细层区分组内商品. GrIS 据此拆出两个设计环节: 先确定商品间的关联, 再据此生成层级编码. 节点携带语义特征, 边携带行为信号, 所得 SID 用于生成式推荐.
-
(基本符号)
- $N$: 全部商品数量; $L$: 层级划分或残差量化的深度;
- $\mathbf X\in\mathbb R^{N\times p}$: 商品文本特征矩阵, $p$ 为特征维度;
- $\mathbf A\in\mathbb R^{N\times N}$: 对称加权邻接矩阵, $A_{ij}$ 表示商品 $i,j$ 的协同关联强度;
- $\operatorname{SID}(i)=(c_i^1,\ldots,c_i^L)$: 商品的多层编码;
- $\mathbf H=f_{\mathrm{GNN}}(\mathbf A,\mathbf X)$: 融入邻居信息后的商品表示.
核心思想
-
(第一条设计轴: 构建协同图) 根据训练交互序列统计 item-item 共现关系. 默认使用相邻交互: 对序列 $(i_1,i_2,i_3)$, 累加 $(i_1,i_2)$ 和 $(i_2,i_3)$ 的共现次数, 再将图对称化. 扩大窗口可纳入更远的关联, 也可按序列距离 $k$ 赋权 $1/k$.
-
(第二条设计轴: 将商品组织成层级编码) GrIS 给出两种实现:
实现 如何使用图 SID 如何产生 RecDMoN 用内容特征和图结构训练可微分簇网络 记录商品在递归划分树上的分支路径 RQ-GAE 图传播生成输入表示, 图重建损失监督量化表示 记录各级残差量化选中的码索引 RQ-VAE 和 RQ-KMeans 对应仅使用节点内容的实例. 建图规则和编码算法可分别替换, 便于分析各自对 SID 的贡献.
-
(RecDMoN: 递归分组) RecDMoN 使用 DMoN 2 完成局部划分. 对含有 $n$ 个商品的当前父簇, 取其诱导子图及节点特征, 用分配网络输出:
$$ \mathbf S=\operatorname{softmax}_{\mathrm{row}}(g_\theta(\mathbf X,\mathbf A))\in\mathbb R^{n\times K}, \qquad \sum_{k=1}^{K}S_{ik}=1. $$此处 $\mathbf A\in\mathbb R^{n\times n}$, $\mathbf X\in\mathbb R^{n\times p}$ 分别为子图的邻接矩阵与节点特征, $K$ 为分支数, $S_{ik}$ 为商品 $i$ 分到子簇 $k$ 的概率. 原始 DMoN 用 GCN 融合节点特征与邻居信息, 经逐行 softmax 得到软分配. 训练后取 $c_i^l=\arg\max_k S_{ik}$, 再对每个子簇的诱导子图重复这一过程. 路径 $(2,1,3)$ 表示依次进入各层父簇的第 $2$, 第 $1$, 第 $3$ 个分支. 共享前缀的商品在相应层级属于同一分组.
-
(DMoN 目标: 模块度与防坍缩) 对每个当前子图重新计算:
$$ \bm d=\mathbf A\bm 1_n\in\mathbb R^n, \qquad m=\frac12\bm 1_n^\top\bm d, \qquad \mathbf B=\mathbf A-\frac{\bm d\bm d^\top}{2m}\in\mathbb R^{n\times n}. $$$d_i$ 是节点 $i$ 的加权度, $m$ 是无向图的总边权, $2m$ 是所有节点度之和. $\bm 1_n$ 为全 $1$ 向量, $\mathbf B$ 为模块度矩阵 (modularity matrix). RecDMoN 沿用 DMoN 的目标:
$$ \mathcal L_{\mathrm{DMoN}}=\underbrace{-\frac{1}{2m}\operatorname{tr}(\mathbf S^\top\mathbf B\mathbf S)}_{\mathcal L_{\mathrm{mod}}}+\underbrace{\frac{\sqrt K}{n}\|\mathbf S^\top\bm 1_n\|_2-1}_{\mathcal L_{\mathrm{collapse}}}. $$$\mathbf S^\top\mathbf B\mathbf S$ 为 $K\times K$ 矩阵, 取迹得到标量; $\mathbf S^\top\bm 1_n$ 为 $K$ 维簇大小向量.
-
模块度项: 模块度最大化是许多图聚类与社区发现方法采用的目标, 模块度谱聚类也基于这一目标. 硬分配将两个节点同簇记为 $1$, 异簇记为 $0$; 软分配用两行概率向量的内积替代:
$$ \operatorname{tr}(\mathbf S^\top\mathbf B\mathbf S)=\sum_{i,j}\left(A_{ij}-\frac{d_i d_j}{2m}\right)\underbrace{\sum_{k=1}^{K}S_{ik}S_{jk}}_{\text{软同簇程度}}. $$其中:
- $A_{ij}$: 实际观察到的连接权重;
- $d_i d_j/(2m)$: 保留节点度数的随机连接基线下的预期连接权重. 节点度数越高, 基线越高;
- $B_{ij}$: 实际连接超过基线的程度. $B_{ij} > 0$ 时, 将二者分到同簇提高模块度; $B_{ij} < 0$ 时, 同簇会降低模块度;
- $1/(2m)$: 按图的总连接规模归一化; 前面的负号将最大化模块度转为最小化损失.
这一项寻找连接强于随机基线的商品群体, 避免仅因热门商品共现较多就将其聚在一起.
-
防坍缩项: 令
$$ \bm t=\mathbf S^\top\bm 1_n\in\mathbb R^K, \qquad t_k=\sum_{i=1}^{n}S_{ik}, \qquad \sum_{k=1}^{K}t_k=n. $$$t_k$ 是第 $k$ 个子簇的软节点数量. 在总量固定为 $n$ 时, $\|\bm t\|_2$ 越小, 分配越均衡:
分配情况 $\bm t$ $\mathcal L_{\mathrm{collapse}}$ 各簇均衡 $(n/K,\ldots,n/K)$ $0$ 全部挤入一个簇 $(n,0,\ldots,0)$ $\sqrt K-1$ 除以 $n$ 消除节点数量的影响, 乘以 $\sqrt K$ 再减去 $1$ 使均衡分配对应零点. 减去 $1$ 不改变梯度. 该项鼓励簇大小均衡, 避免大量商品集中在少数分支.
-
两项如何配合: 将模块度项展开, 完整目标还可以写成:
$$ \mathcal L_{\mathrm{DMoN}}=-\frac{\operatorname{tr}(\mathbf S^\top\mathbf A\mathbf S)}{2m}+\frac{\|\mathbf S^\top\bm d\|_2^2}{(2m)^2}+\frac{\sqrt K}{n}\|\mathbf S^\top\bm 1_n\|_2-1. $$第一部分奖励簇内实际连接; 第二部分根据各簇总度 $\mathbf S^\top\bm d$ 扣除随机基线; 第三部分约束软簇大小 $\mathbf S^\top\bm 1_n$. 模块度决定哪些节点聚在一起, 防坍缩项控制分配是否集中. 所有节点均输出 $S_{ik}=1/K$ 时, 两项均为 $0$; 模块度为正且分配均衡的划分可获得更低损失, 见附录算例.
-
-
(RQ-GAE: 图传播与残差量化结合) RQ-GAE 先用 APPNP 传播商品特征, 再通过 MLP 得到 $\bm z_i\in\mathbb R^{d_z}$. 以 $\bm r_i^1=\bm z_i$ 为初始残差, 每层选择最近的码向量:
$$ c_i^l=\arg\min_k\|\bm r_i^l-\bm b_k^l\|_2^2, \qquad \bm r_i^{l+1}=\bm r_i^l-\bm b_{c_i^l}^l, \qquad \bm q_i=\sum_{l=1}^{L}\bm b_{c_i^l}^l. $$$\bm b_k^l\in\mathbb R^{d_z}$ 是第 $l$ 层的第 $k$ 个码向量, $\bm q_i$ 为最终量化表示. 实验使用四个大小为 $256$ 的码本. APPNP 的系数 $\alpha$ 控制保留初始表示的比例: $\alpha$ 越大, 内容保留越多; 越小, 邻域传播的影响越强.
-
(图重建损失直接约束量化结果) 在一个 mini-batch $\mathcal B$ 内, 用归一化量化向量 $\bar{\bm q}_i=\bm q_i/\|\bm q_i\|_2$ 定义邻居概率:
$$ p_\theta(j\mid i,\mathcal B)=\frac{\exp(\bar{\bm q}_i^\top\bar{\bm q}_j/\tau)}{\sum_{k\in\mathcal B,\,k\ne i}\exp(\bar{\bm q}_i^\top\bar{\bm q}_k/\tau)}, \qquad j\ne i. $$$\tau$ 为温度, $w_{ij}$ 为 batch 内两商品的图边权, $\mathcal B_+$ 为 batch 内至少有一个邻居的锚点集合. 图损失为:
$$ \mathcal L_{\mathrm{graph}}=-\frac{1}{|\mathcal B_+|}\sum_{i\in\mathcal B_+}\sum_{j\in\mathcal B,\,j\ne i}w_{ij}\log p_\theta(j\mid i,\mathcal B), \qquad \mathcal L=\mathcal L_{\mathrm{RQ}}+\beta\mathcal L_{\mathrm{graph}}. $$$\mathcal L_{\mathrm{RQ}}$ 包括 RQ-VAE 的重构与量化目标, $\beta$ 控制图监督强度. 共现越频繁, 正向监督权重越大; batch 中其余商品参与 softmax 归一化. 图传播将协同信息引入输入表示, 图损失使量化表示保留这种关系.
关键洞察
-
(推荐效果) SID 方法统一使用 TIGER 的 T5 生成骨干, 比较不同编码构造策略; S2GR 在这里使用其 tokenizer, 去掉后续 reasoning 模块. 实验采用 5-core, leave-one-out 划分和三次随机种子平均. Table 3 的 Hit@10 (%) 如下:
数据集 TIGER LETTER RecDMoN RQ-GAE Beauty 5.84 6.18 7.96 6.87 Sports 3.46 3.42 4.72 3.75 Toys 5.24 5.37 8.16 6.51 Books 3.11 3.43 — 4.60 MIND 9.53 13.29 15.69 13.49 Yelp 2.14 1.46 — 2.68 RecDMoN 在三个小型 Amazon 数据集上表现突出, Toys 相对 LETTER 提高 $52.0\%$. Books 上 RQ-GAE 最优; MIND 上整体最佳方法为 HSTU, Hit@10 为 $18.32\%$; Yelp 上纯图 Spectral 最优, 为 $4.30\%$. 不同数据集对语义组织和协同结构的需求有所区别.
-
(图监督的直接作用) Table 5 的 Beauty 实验中, 基础模型 Hit@10 为 $5.84\%$, 仅加图损失为 $6.82\%$, 仅使用图传播输入为 $5.66\%$, 两者结合为 $6.87\%$. 直接约束量化表示保留协同关系, 是该实验中的主要收益来源.
-
(实现规模) 本文 RecDMoN 使用稠密邻接矩阵, 在 Books 上超出 GPU 显存, Books 和 Yelp 仅报告 RQ-GAE 结果. 原始 DMoN 可利用稀疏 $\mathbf A$ 和低秩度数项计算模块度, 通过上述展开式避免构造稠密 $\mathbf B$.
继往开来
-
GrIS 通过建图与编码两个环节融合协同信息: RecDMoN 递归构造分区树, RQ-GAE 在残差量化中保留图关系.
-
DMoN 聚合超出随机基线的联系, 同时均衡分支大小, 分别对应前缀内的行为一致性与前缀空间的利用程度. 协同图, 分配网络与递归策略均可独立改进.
附录
-
(用四个节点理解 DMoN) 考虑仅有两条无向边 $(1,2)$ 和 $(3,4)$ 的图, 边权均为 $1$, 划分为 $K=2$ 个簇. 此时 $n=4$, $m=2$, 每个节点的度均为 $1$, 随机基线 $d_i d_j/(2m)=1/4$. 记模块度为 $Q=\operatorname{tr}(\mathbf S^\top\mathbf B\mathbf S)/(2m)$:
分配方式 模块度 $Q$ 防坍缩项 总损失 $-Q+\mathcal L_{\mathrm{collapse}}$ $\{1,2\}$ 和 $\{3,4\}$ 各成一簇 $1/2$ $0$ $-1/2$ $\{1,3\}$ 和 $\{2,4\}$ 各成一簇 $-1/2$ $0$ $1/2$ 所有节点进入同一簇 $0$ $\sqrt2-1$ $\sqrt2-1$ 每个节点都输出 $(1/2,1/2)$ $0$ $0$ $0$ 前两种划分同样均衡, 由模块度区分优劣; 第三种受到防坍缩项惩罚; 第四种虽均衡, 但损失高于正确的社区划分.
-
(防坍缩项为何以均衡分配为最小值) 因为 $t_k\ge0$ 且 $\sum_k t_k=n$, 有:
$$ \frac{n}{\sqrt K}\le\|\bm t\|_2\le n, \qquad 0\le\frac{\sqrt K}{n}\|\bm t\|_2-1\le\sqrt K-1. $$左侧等号在所有 $t_k=n/K$ 时成立, 右侧等号在只有一个 $t_k=n$ 时成立. 该项度量软簇大小的不均衡程度, 不要求单个节点作硬分配.
参考文献
- Medvedev A., Ariza-Casabona A., Derby S., Fiz Pontiveros G., Shao X. and Spiess F. Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS). CIKM, 2026. [PDF] [Code]
- Tsitsulin A., Palowitch J., Perozzi B. and Müller E. Graph Clustering with Graph Neural Networks. Journal of Machine Learning Research, 24(127): 1-21, 2023. [Paper]