Guiding the coarse levels of semantic IDs makes the fine levels learnable
Content
研究背景
-
(Semantic ID) TIGER 用 RQ-VAE 将 item embedding 转为多级离散编码, 再自回归生成 SID 完成检索. 但量化器通常只优化重构, 最先生成的粗层编码未必对应推荐任务真正关心的属性, 也未必容易从用户上下文推断.
-
(粗层错误会向后传递) 若第一层选错, 后续解码就进入错误分支. Guided SID 的想法很直接: 与其让模型事后理解一个自由形成的粗层编码, 不如事先规定该层表达什么. 作者选择广告 targeting country, 因为它与投放任务相关, 与内容存在关联, 且服务系统在选择候选前就能提供相关属性信息.
-
(符号说明)
- $x$: 一个 item, 本文实验中为广告;
- $z=f(x)\in\mathbb{R}^d$: 冻结内容编码器 $f$ 输出的 embedding;
- $E,D$: RQ-VAE 的可学习 encoder 与 decoder; $h=E(z)\in\mathbb{R}^{d'}$ 为量化空间中的表示;
- $L,K$: 量化层数与每层码本大小, 本文分别为 6 和 256; 层索引 $\ell=0,\ldots,L-1$;
- $C_\ell\in\mathbb{R}^{K\times d'}$: 第 $\ell$ 层的可学习码本; $C_\ell[k]$ 为索引 $k$ 对应的码向量;
- $r_\ell\in\mathbb{R}^{d'}$: 进入第 $\ell$ 层的残差, 初始 $r_0=h$;
- $c_\ell\in\{0,\ldots,K-1\}$: 第 $\ell$ 层选中的离散索引; $(c_0,\ldots,c_{L-1})$ 构成完整 SID;
- $\mathcal G$: 受属性引导的层集合, 实验中为 $\{0\}$;
- $a_\ell(x)\in\{0,\ldots,K-1\}$: item 属性经过 trie-merge 等映射后, 分配给引导层的标签索引, 不一定对应未经合并的原始属性值;
- $\hat h=\sum_{\ell=0}^{L-1}C_\ell[c_\ell]$: 量化后的表示; $\hat z=D(\hat h)$ 为重构的内容 embedding.
核心思想
-
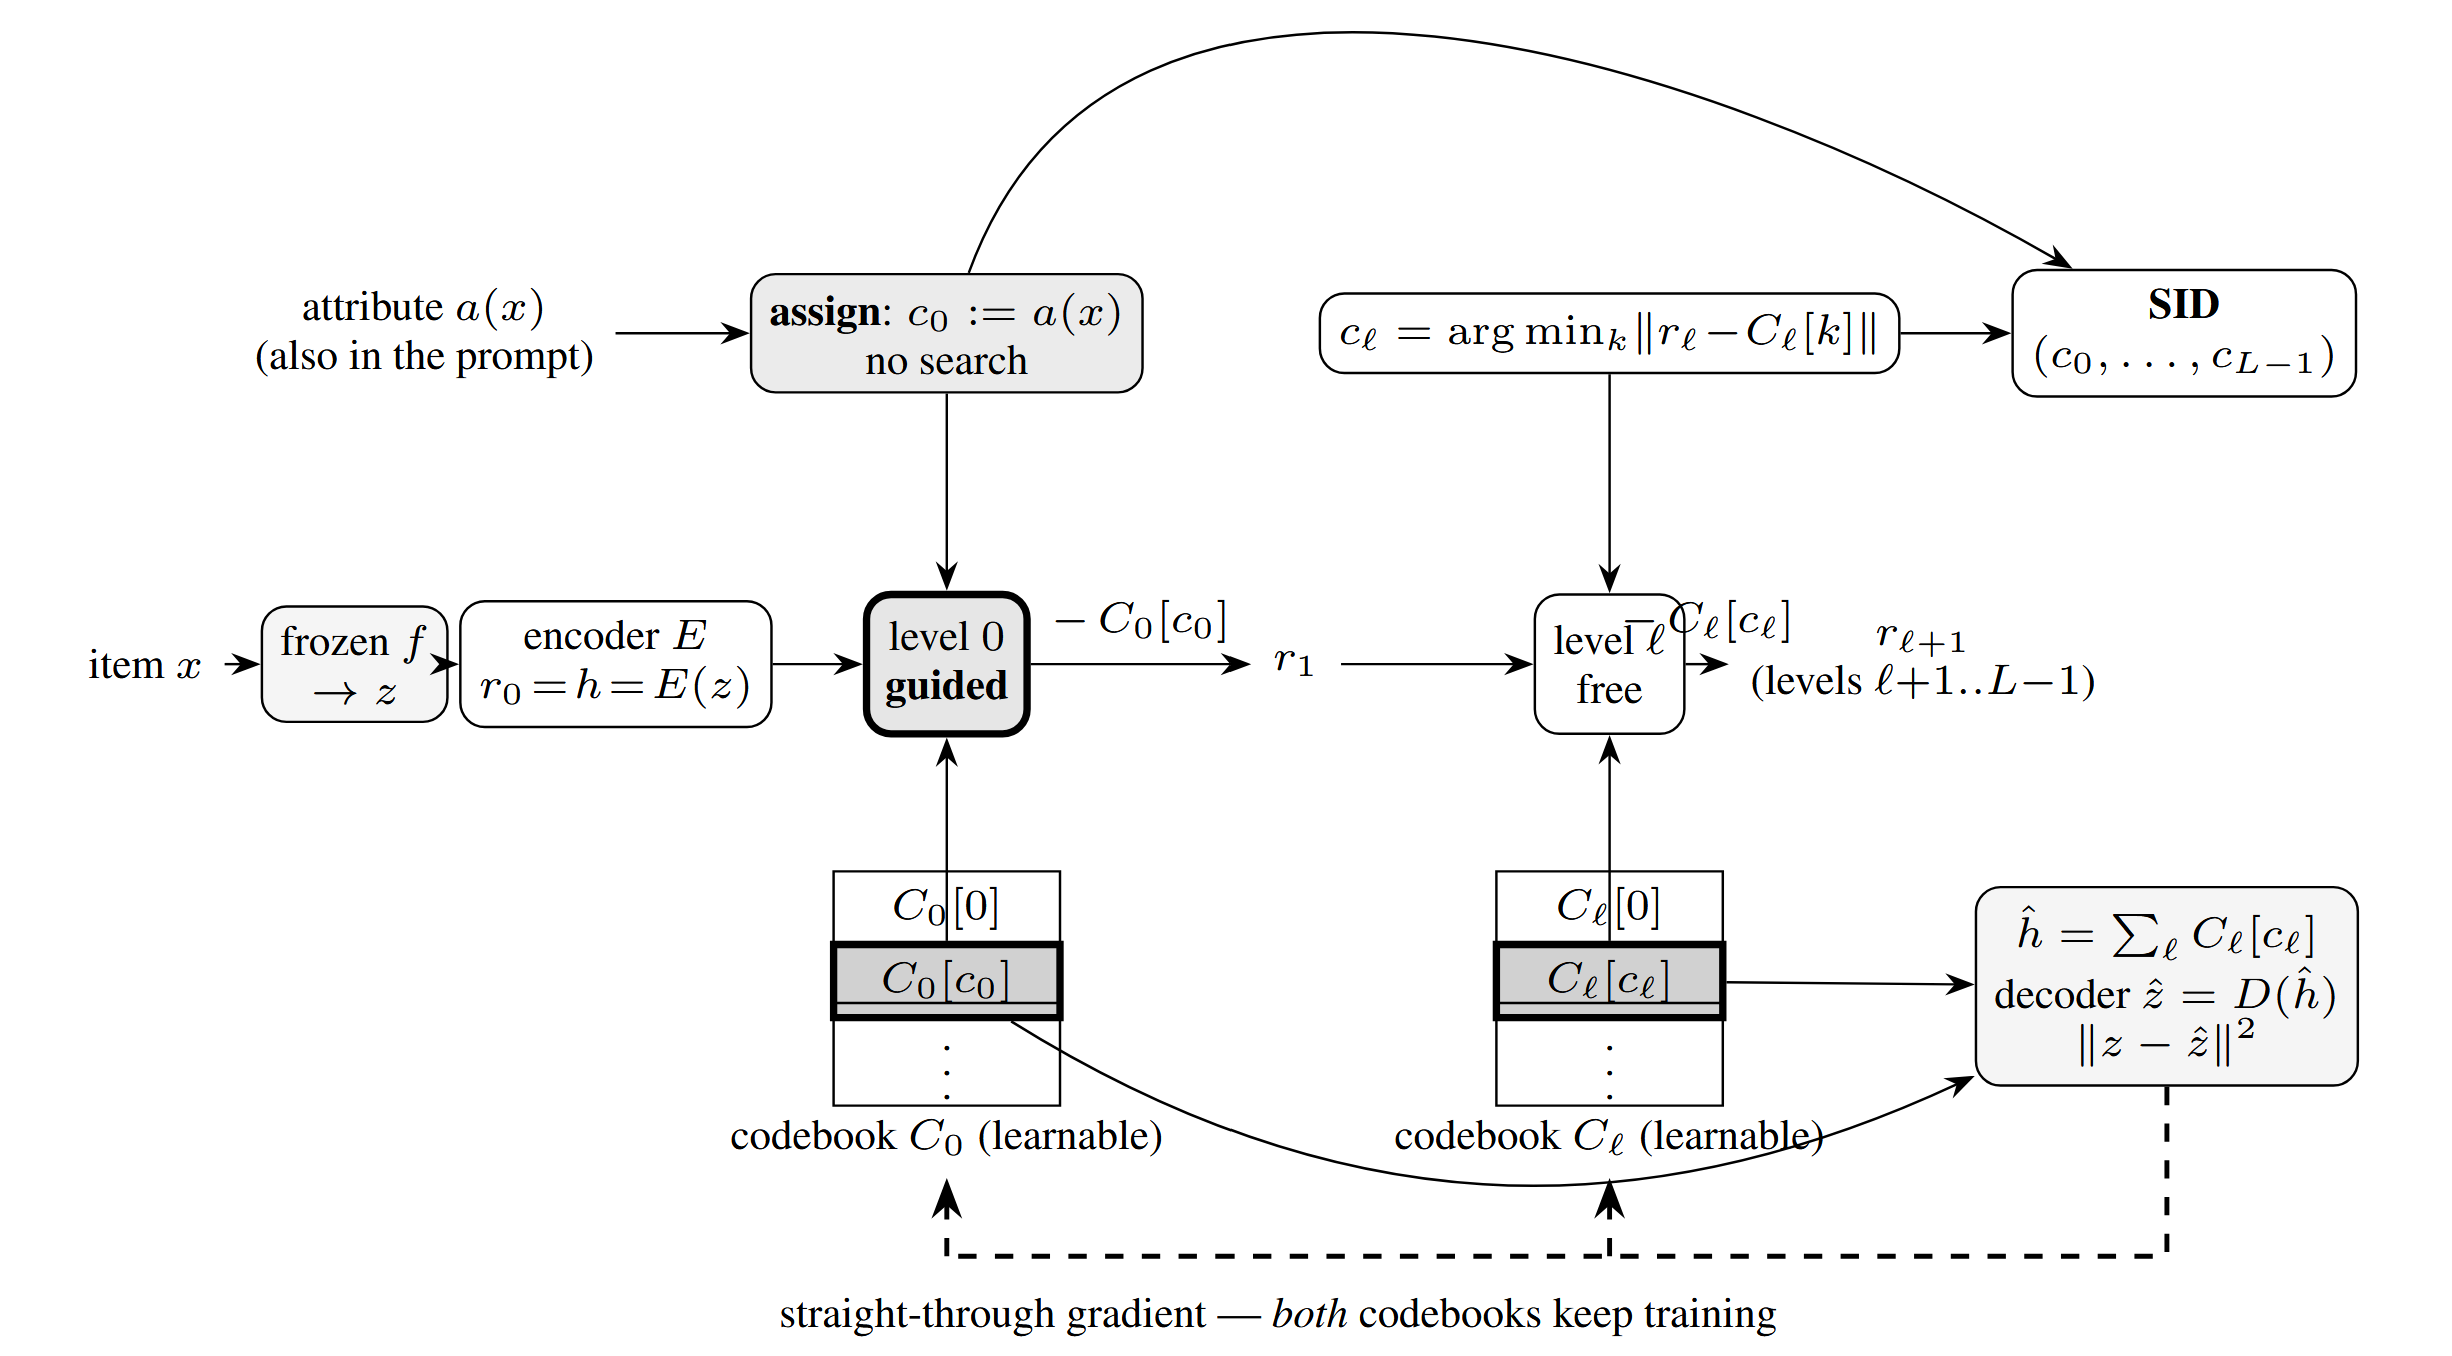
(普通残差量化) 对冻结内容编码器得到的 $z$, 先由 RQ-VAE encoder 映射为 $h=E(z)$. 初始化 $r_0=h$, 各层选择最近码向量并更新残差:
$$ c_\ell =\arg\min_k\|r_\ell-C_\ell[k]\|_2^2, \qquad r_{\ell+1} =r_\ell-C_\ell[c_\ell]. $$最后用 $\hat h=\sum_\ell C_\ell[c_\ell]$ 重构输入 embedding. 本文统一使用 6 层、每层 256 个码.
-
(Guided Assignment) 在指定的引导层, 用 item 属性对应的标签直接替代最近邻选择:
$$ c_\ell = \begin{cases} a_\ell(x), & \ell\in\mathcal G,\\ \arg\min_k\|r_\ell-C_\ell[k]\|_2^2, & \ell\notin\mathcal G. \end{cases} $$实验只引导第一层, 即 $\mathcal G=\{0\}$. 固定的是属性到索引的对应关系, 码向量 $C_0[a_0(x)]$ 仍参与训练. 残差更新、后续最近邻量化和重构目标继续保留. 因此, 同一属性桶的 item 共享首码, 后五层编码减去该属性码向量之后的残差.
-
(为什么可能影响细层?) 首层向量变了, 后续接收的残差分布也随之改变. 若属性与内容相关, 同桶样本就有可利用的共同结构, 后续量化可以围绕它学习差异. 虽然没有直接监督细层索引, 它们的学习问题已经被粗层划分重新组织.
-
(Trie-Merge: 将属性压进码本预算) 广告可能面向多个国家, 组合数远超过 256. 作者先将属性表示为 trie 路径: 国家集合按全局流行度排序, 类目则沿分类树展开. 然后自底向上, 反复选择最小子节点对应的父节点, 合并其两个最小兄弟节点, 直到只剩 256 个叶桶. 这样尽量让共享前缀的长尾值合并, 避免简单地将所有低频属性塞进一个 other 桶.
-
(与前置属性 token 的区别) 三种方案的结构分别为:
方案 SID 结构 原内容量化是否改变 Vanilla 6 个自由量化码 否 Prepended 属性 token + 原来的 6 个码 否 Guided 属性指定首码 + 5 个自由残差码 是 Guided 消耗一个原有量化层来表达属性, 同时改变后续残差; Prepended 增加序列长度, 保持原内容码不变.
关键洞察
-
(属性不是越直观越好) 引导属性需要与内容和任务相关, 推理时可获得, 覆盖充分且稳定. 合并后的桶也不保证均衡: 国家桶中最大的占 22.1%, 前十个占 63.6%. 这会限制首码携带的信息量. 对年龄、性别等主要表达投放约束的外部属性, 作者也认为前置 token 可能更合适, 不必全部塞进内容量化层.
-
(验证范围) 实验使用私有工业广告数据, 只测试 targeting country 和单层引导. 文中 A/B 是匹配训练与离线评估对照, 不是线上业务指标实验; 作者明确尚无 guided RL 或部署中的 serving model. 多属性、多层引导及其他推荐数据上的效果仍待验证.
继往开来
-
Guided SID 将 SID 设计从"重构哪些信息"推进到"哪些信息应该最先被生成". 当某个任务相关属性在推理时可知, 可以用它组织编码空间, 让生成顺序与任务约束更一致.
-
其价值不在于给 SID 加了一个可解释名字, 而在于属性参与了残差量化本身. 后续值得验证的是, 在控制粗层正确率和码长后, 细层条件预测是否仍有独立收益, 以及这一收益如何随属性相关性与桶分布变化.
参考文献
- Wang B. and Zhang Z. Guiding the coarse levels of semantic IDs makes the fine levels learnable. arXiv:2609.22227v1, 2026. [PDF]