REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation
Content
研究背景
-
(关系学习) 生成式推荐中很重要一点是如何保留/迁移 item-item 间的关系, 这些关系涉及到 SID 构建所依赖的语义关系, 历史交互中的共现关系, 以及较为特殊的"教师模型"中所蕴含的偏好关系.
-
(符号说明)
- $i \in \mathcal{I}$, item $i$;
- $\mathbf{s}_i = (s_i^1, \ldots, s_i^L, s_i^{L+1})$, item $i$ 的 SID
- $\mathbf{a}_{\ell} = (s_i^1, \ldots, s_i^{\ell - 1})$, 长度为 $\ell - 1$ 的前缀;
- $\mathcal{P}$, SID 所形成的树中所有潜在前缀的集合;
核心思想
-
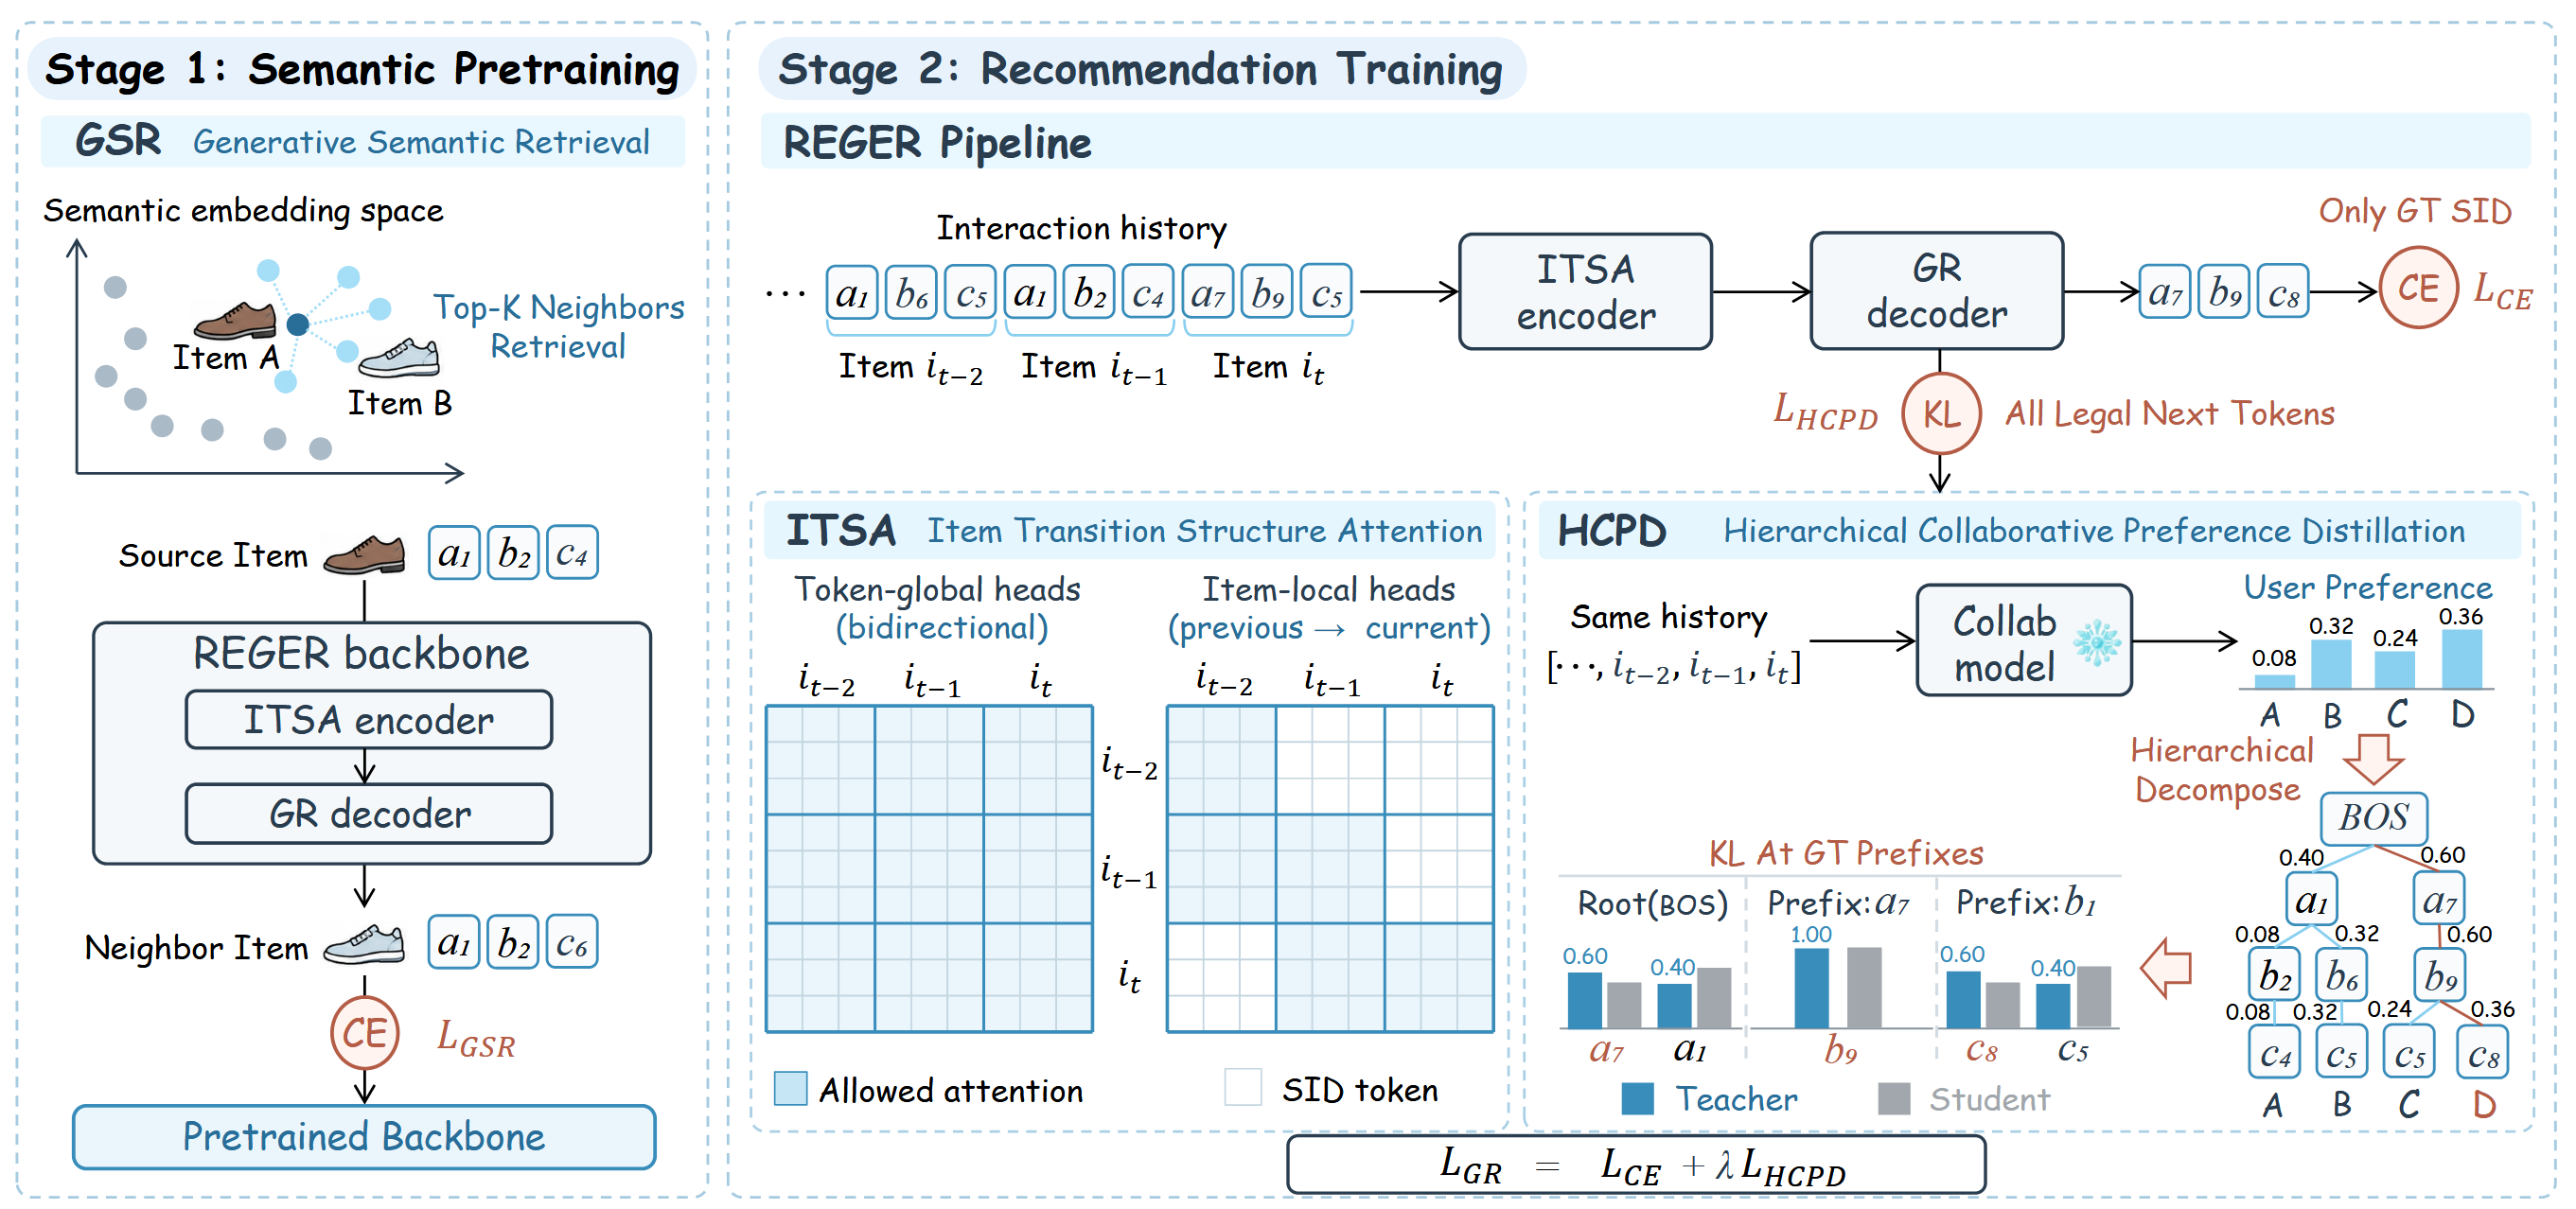
(语义关系) 由于下游的推荐模型的 SID embedding 是随机初始化的, 因此难以保证最终学习到的 SID embedding table 保持了由语义内容所决定的关联关系. 为此, REGER 首先以语义相似作为预训练目标, 即给定 SID $\mathbf{s}_i$, 预测目标是预期语义上相近的 $\mathbf{s}_j$ 而非下一个购买的商品.
-
(共现关系) 传统的 T5 架构的生成式推荐模型, encoder 采用双向注意力头, 为了进一步强调同一序列中前后交互商品的共现关系, 设计
- 全局头: 对全部历史 token 做双向注意力, 保留远距离历史关系.
- 局部头: 当前商品的每个 token 只能读取本商品和紧邻的前一个商品的全部 SID token, 在这个窗口内共同归一化.
-
(偏好蒸馏) 生成式推荐所依赖的 next-token prediction 损失驱动的是给定特定历史交互何种 SID 分支最精确, 但是却不能保证对于其他分支的监督. 因此 REGER 希望引入一个外部模型来进行进一步指导其他分支的学习. 总得来说, 假设 $P(i)$ 是学生分布预测 item $i$ 的概率 (省略历史交互符号), 相应的 $Q(i)$ 表示教师分布预测 item $i$ 的概率, 我们所期望的蒸馏为
$$ \tag{1} D_{\text{KL}}(P \| Q) = \sum_{i \in \mathcal{I}} P(i) \log \frac{P(i)}{Q(i)}, $$然而, 对于生成式模型而言, 估计完整 $P(i), i \in \mathcal{I}$ 的开销是不可接受的. 本文首先将其转换为分支上的 mass, 记 $\mathcal{I}(\mathbf{a}) = \{i: \mathbf{s}_i^{< \ell} = \mathbf{a}, \exist \ell\}$ 表示所有以 $\mathbf{a}$ 为前缀的 item 集合, 则其上的概率 mass 有
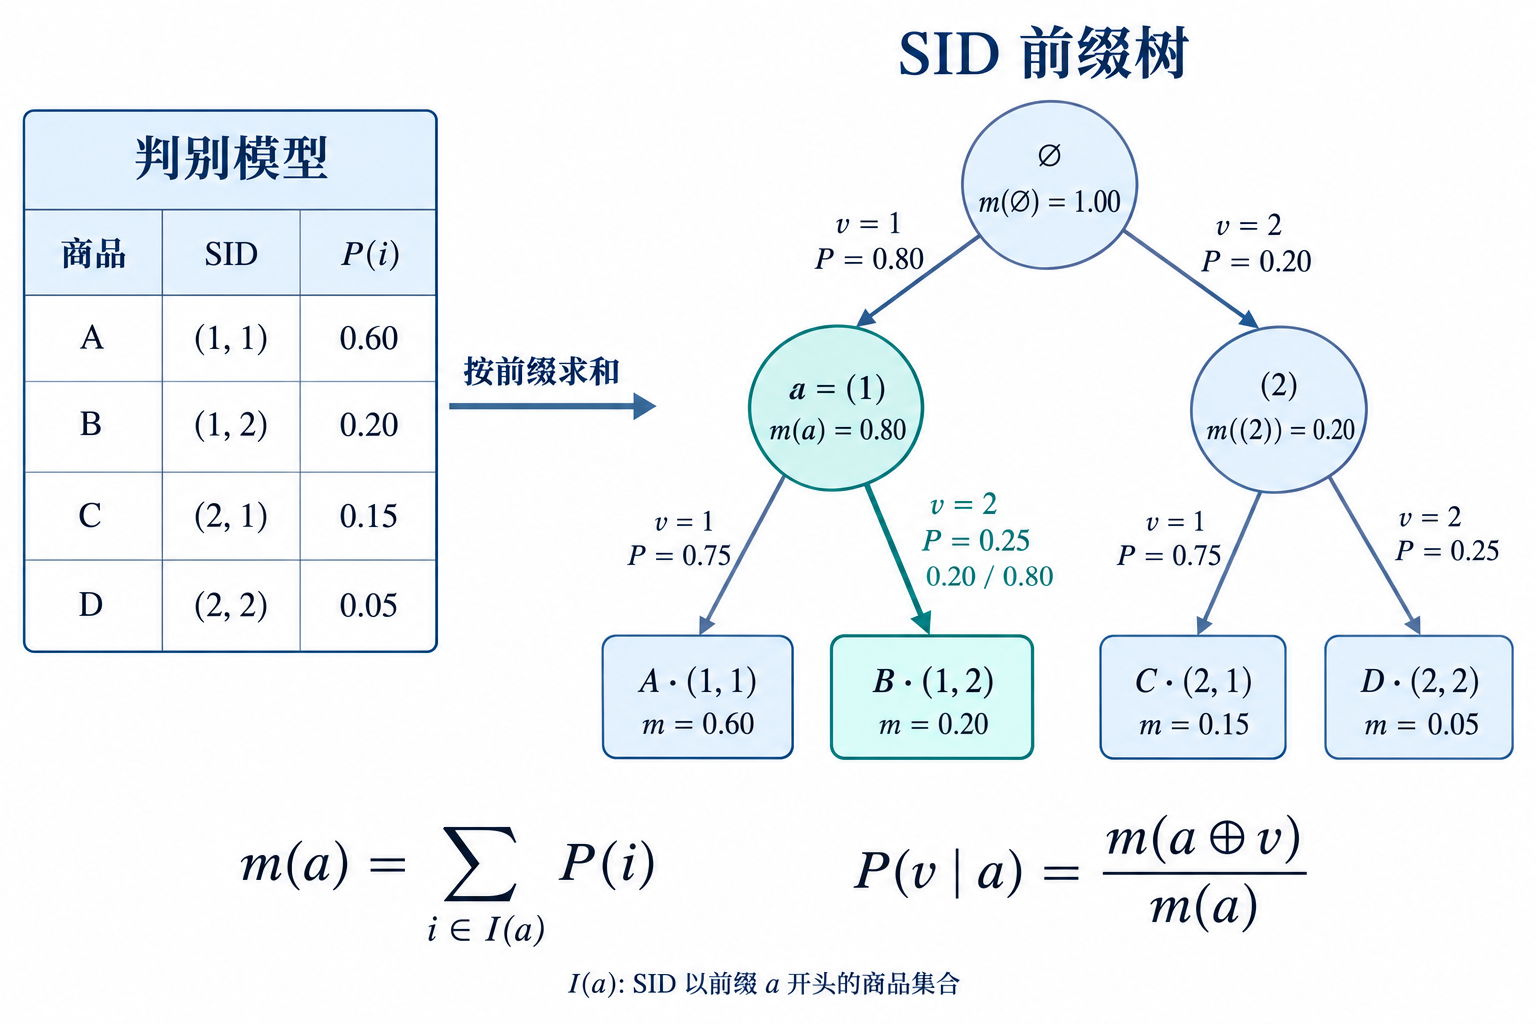
$$ m_P(\mathbf{a}) = \sum_{i \in \mathcal{I}(\mathbf{a})} P(i), \quad P(v|\mathbf{a}) = \frac{m_{P}(\mathbf{a}\oplus v)}{m_P (\mathbf{a})}. $$由此, (1) 可以等价地改写为
$$ \begin{align*} D_{\text{KL}}(P \| Q) &= \sum_{i \in \mathcal{I}} P(i) \log \frac{P(i)}{Q(i)} \\ &= \sum_{i \in \mathcal{I}} P(i) \log \frac{\prod_{\ell=1}^{L+1} P(v_{\ell}| \mathbf{s}_i^{<\ell})}{\prod_{\ell=1}^{L+1} Q(v_{\ell}| \mathbf{s}_i^{<\ell})} \\ &= \sum_{\ell=1}^{L+1}\sum_{i \in \mathcal{I}} P(i) \log \frac{P(v_{\ell}| \mathbf{s}_i^{<\ell})}{Q(v_{\ell}| \mathbf{s}_i^{<\ell})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} \sum_{i \in \mathcal{I}} \mathbb{I}[\mathbf{s}_i^{<\ell} = \mathbf{a}, v_{\ell} = v] P(i) \log \frac{P(v| \mathbf{s}_i^{<\ell})}{Q(v| \mathbf{s}_i^{<\ell})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} \sum_{i \in \mathcal{I}(\mathbf{a} \oplus v)} P(i) \log \frac{P(v| \mathbf{a})}{Q(v| \mathbf{a})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} \left( \sum_{i \in \mathcal{I}(\mathbf{a} \oplus v)} P(i) \right) \log \frac{P(v| \mathbf{a})}{Q(v| \mathbf{a})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} m_P(\mathbf{a} \oplus v) \log \frac{P(v| \mathbf{a})}{Q(v| \mathbf{a})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} m_P(\mathbf{a}) P(v|\mathbf{a}) \log \frac{P(v| \mathbf{a})}{Q(v| \mathbf{a})} \\ &= \sum_{\mathbf{a} \oplus v \in \mathcal{P}} m_P(\mathbf{a}) D_{\text{KL}} \left(P(\cdot |\mathbf{a})\| Q(\cdot |\mathbf{a}) \right). \end{align*} $$转换成如此结果, 精确的计算依旧是难以企及的. 作者的想法是把其中最难的 $m_P(\mathbf{a})$ 给舍弃, 专注 $D_{\text{KL}} \left(P(\cdot |\mathbf{a})\| Q(\cdot |\mathbf{a}) \right)$ 的计算. 对于一般的生成式推荐模型而言, 给定任意 item, 我们都可以比较方便的计算出其各前缀所对应的 $\mathbf{P}(\cdot|\mathbf{a})$. 稍微特别的点在于, 作者认为计算的时候需要规避掉那些 invalid SID 前缀.
-
(判别式模型作为教师) 判别式模型只有每个 item $Q(i)$, 如何估计 $Q(\cdot|\mathbf{a})$ 呢? 只需根据如下公式计算即可
$$ Q(v|\mathbf{a}) = \frac{ \sum_{i \in \mathcal{I}(\mathbf{a} \oplus v)} Q(i) }{\sum_{i \in \mathcal{I}(\mathbf{a})} Q(i)}. $$
关键洞察
-
(主要收益来源) 三个模块的移除实验都会降低效果, 其中去掉 HCPD 的影响最大: Beauty、Sports、Toys 的 Recall@5 分别下降约 $13.5\%$、$10.9\%$、$18.0\%$. 将 HCPD 单独加入 TIGER 也能稳定提升表现, 说明它的价值不限于与 GSR、ITSA 配合.
-
(推荐效果) 主实验采用 5-core、leave-one-out 划分, 历史最多保留 $20$ 个商品, 结果为三次运行的均值. 下表为 Amazon 2014 的 NDCG@10:
方法 Beauty Sports Toys TIGER 0.0367 0.0231 0.0355 TIGER + HCPD 0.0445 0.0269 0.0440 DuoRec 教师 0.0454 0.0248 0.0493 REGER 0.0484 0.0296 0.0496 REGER 在三组数据的所有指标上优于所比较的生成式与混合方法. 与 DuoRec 相比, NDCG@10 均更高, 但 Beauty 和 Toys 的 Recall@10 分别为 $0.0870$、$0.0934$, 仍低于教师的 $0.0875$、$0.0961$. Amazon 2023 的三组数据也支持其效果.
-
(教师分布的质量) 教师的 Top-$K$ 精度不能完全代表蒸馏价值. Scientific 上, DuoRec 各项指标低于未蒸馏的 REGER, 仍能帮助学生提升. 但换用 SASRec 教师时, 2014 三组数据的 Recall@50 提升, Recall@5 和 NDCG@5 却下降. 蒸馏既可能补充被低估的候选, 也可能传递不准确的偏好.
-
(训练与推理成本) 在 Beauty 的单卡 L40、FP32、batch 256 实验中, TIGER 加入 HCPD 后每 epoch 从 $19$ 秒增至 $23$ 秒, 测试集推理时间均为 $16$ 秒. 此比较关闭 KV cache, 反映的是新增训练目标的开销. GSR 是额外的预训练阶段, 教师在推荐训练中冻结.
继往开来
-
REGER 将“SID 保存了什么关系”进一步推进到“生成模型如何使用这些关系”: 邻居生成提供语义初始化, 注意力 mask 显式组织商品转移, 条件蒸馏使用户偏好进入每一步分支选择.
-
HCPD 的关键在于将一次 token 选择解释为对一组候选商品的选择. 由此可以在保持自回归形式的同时, 为非目标分支提供有强弱之分的监督.
参考文献
- Huang Y., Zhou S., Wang C., Li Z., Guo G., Ke P., Gao S. and Shang S. REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation. arXiv, 2026. [PDF]