S²GR: Stepwise Semantic-Guided Reasoning in Latent Space for Generative Recommendation
Content
研究背景
-
(推理与 SID 生成) TIGER 根据用户历史直接生成多位 Semantic ID. 潜在推理方法增加连续隐藏状态以提高计算深度, 但如果全部思考集中在 SID 生成之前, 后续编码位置就缺少独立的中间计算与监督.
-
(S²GR) 作者提出两项相互配合的改进: 先用协同信息、码本均匀性和负载均衡改进 RQ-VAE, 再在每一位 SID 前插入 thinking token, 用该层码本的粗粒度聚类监督其语义. 这里的 reasoning 是连续向量上的额外计算, 不生成自然语言推理链.
-
(符号说明)
- $\mathbf{X}$: item 原始内容向量矩阵; $\mathbf{A}$: item 共现图的加权邻接矩阵.
- $\mathbf{D}$: 度矩阵; $\widehat{\mathbf{A}}=\mathbf{D}^{-1/2}\mathbf{A}\mathbf{D}^{-1/2}$: 归一化邻接矩阵.
- $\mathbf{H}^{(k)}$: 第 $k$ 次图传播后的 item 表示; $K_g$: 最大传播次数.
- $L$: SID 长度, 实验取 $3$; $s_l$: 第 $l$ 位 SID 编码.
- $\bm{e}_l^j$: 第 $l$ 层码本的第 $j$ 个码向量; 每层码本大小为 $256$.
- $\mathbf{H}_{\mathrm{enc}}$: 用户历史经 Transformer encoder 编码后的表示.
- $\bm{t}_l$: 生成 $s_l$ 前的连续 thinking 向量; $\bm{p}_l$: 对应层级的位置向量.
- $\bm{c}_{l,k}$: 第 $l$ 层码本的第 $k$ 个聚类中心; $K_c$: 聚类数.
- $\bm{v}_g$: 辅助 decoder 生成的整体兴趣表示; $\overline{\bm{v}}$: 目标 item 各层 SID embedding 的平均值.
- $B$: batch 大小; $\tau$: 对比损失温度; $\operatorname{sg}$: 停止梯度.
核心思想
-
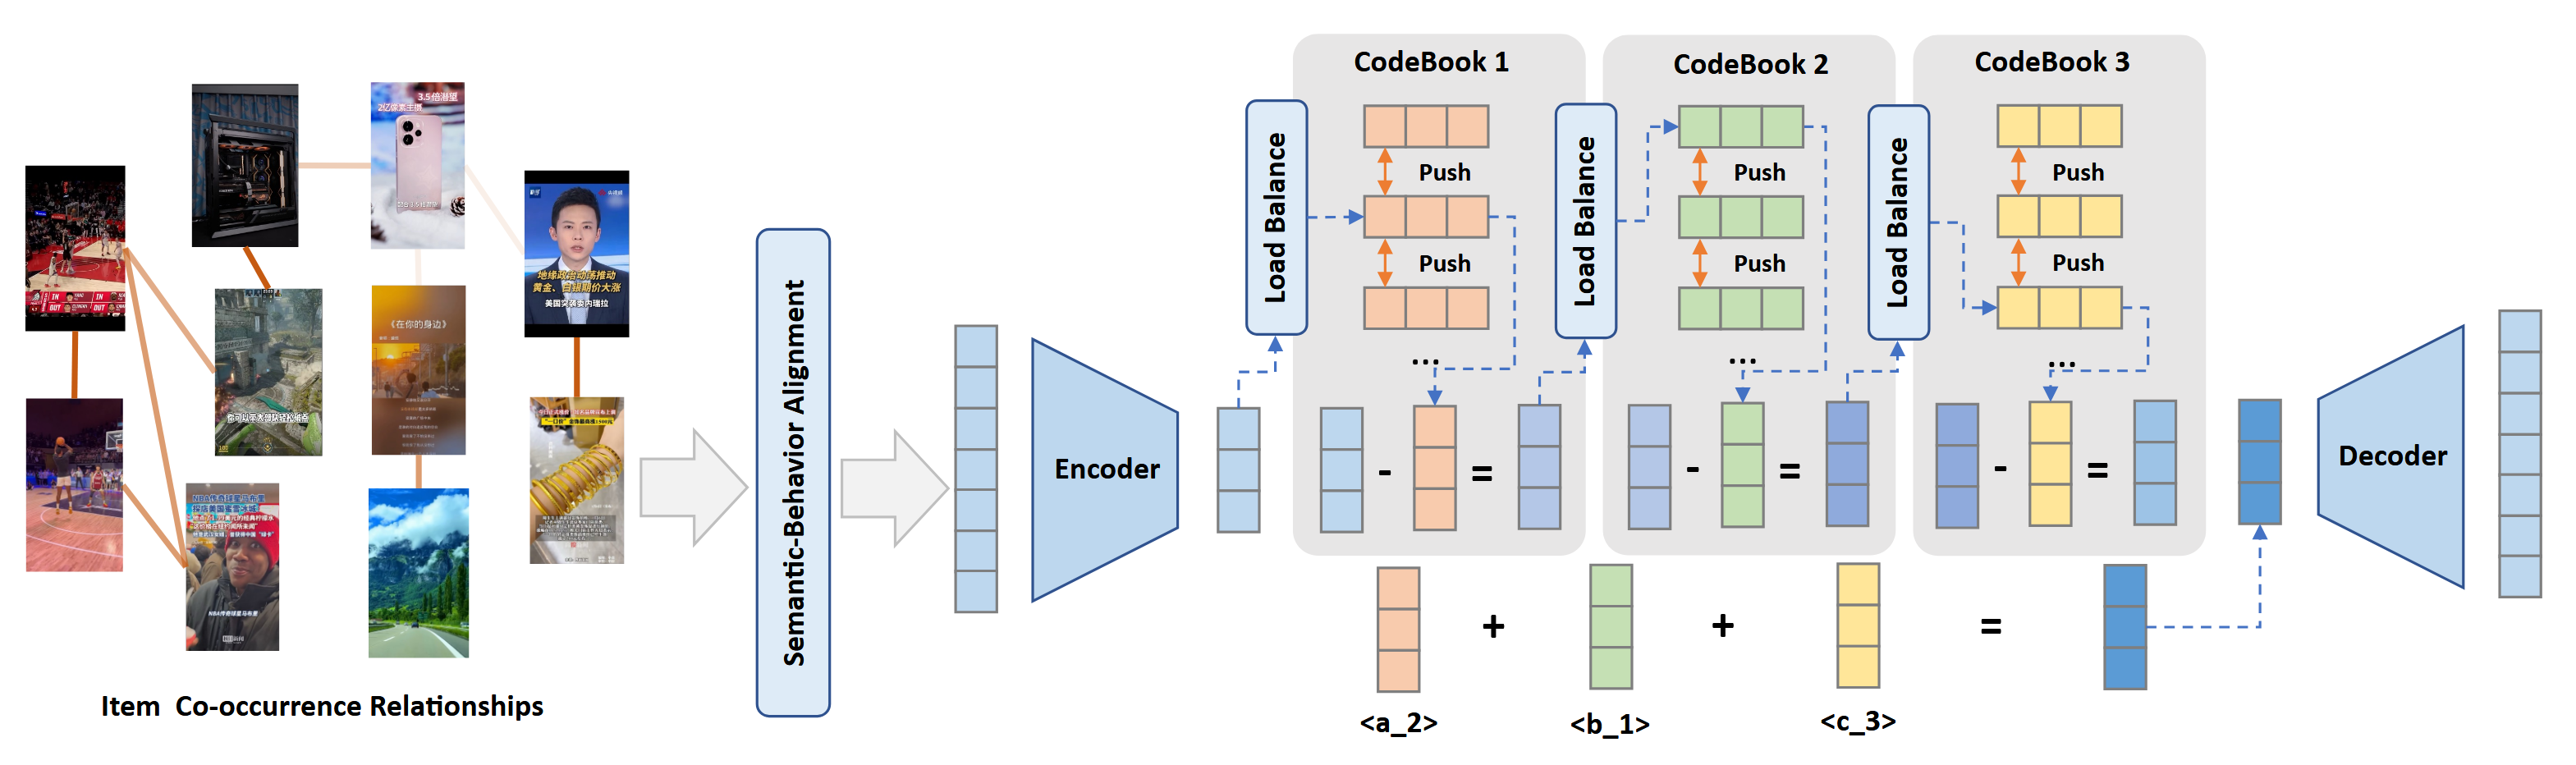
(CoBa RQ-VAE: 融合内容与共现关系) 从用户历史的时间窗口或固定长度窗口构造 item 共现图, 边权为共现次数. 以 $\mathbf{H}^{(0)}=\mathbf{X}$ 初始化, 进行带原始内容保留项的传播:
$$ \mathbf{H}^{(k)}=(1-\alpha)\widehat{\mathbf{A}}\mathbf{H}^{(k-1)}+\alpha\mathbf{X}, \qquad \mathbf{H}_{\mathrm{align}}=\sum_{k=0}^{K_g}\beta_k\mathbf{H}^{(k)}, \qquad \beta_k=\frac{\alpha(1-\alpha)^k}{\sum_{j=0}^{K_g}\alpha(1-\alpha)^j}. $$$\alpha$ 控制原始语义的保留程度. 随后以 $\mathbf{H}_{\mathrm{align}}$ 作为商品的 “semantic embedding” 训练 RQ-VAE, 通过内容相近与行为共现共同塑造 SID, 不需要额外预训练协同过滤模型.
-
(码本分布与使用频率分别优化) 在标准重建和量化目标上加入两种机制:
- 均匀性: 对距离小于阈值的不同码向量施加排斥损失, 避免多个码向量聚集在相近位置.
- 负载均衡: 根据历史激活次数调整最近邻选择距离. 使用较少的码降低选择距离, 使用较多的码提高选择距离, 并限制调整幅度.
两者分别作用于码向量的几何分布和编码的使用频率. 作者将这一 tokenizer 称为 Collaborative and Balanced RQ-VAE.
-
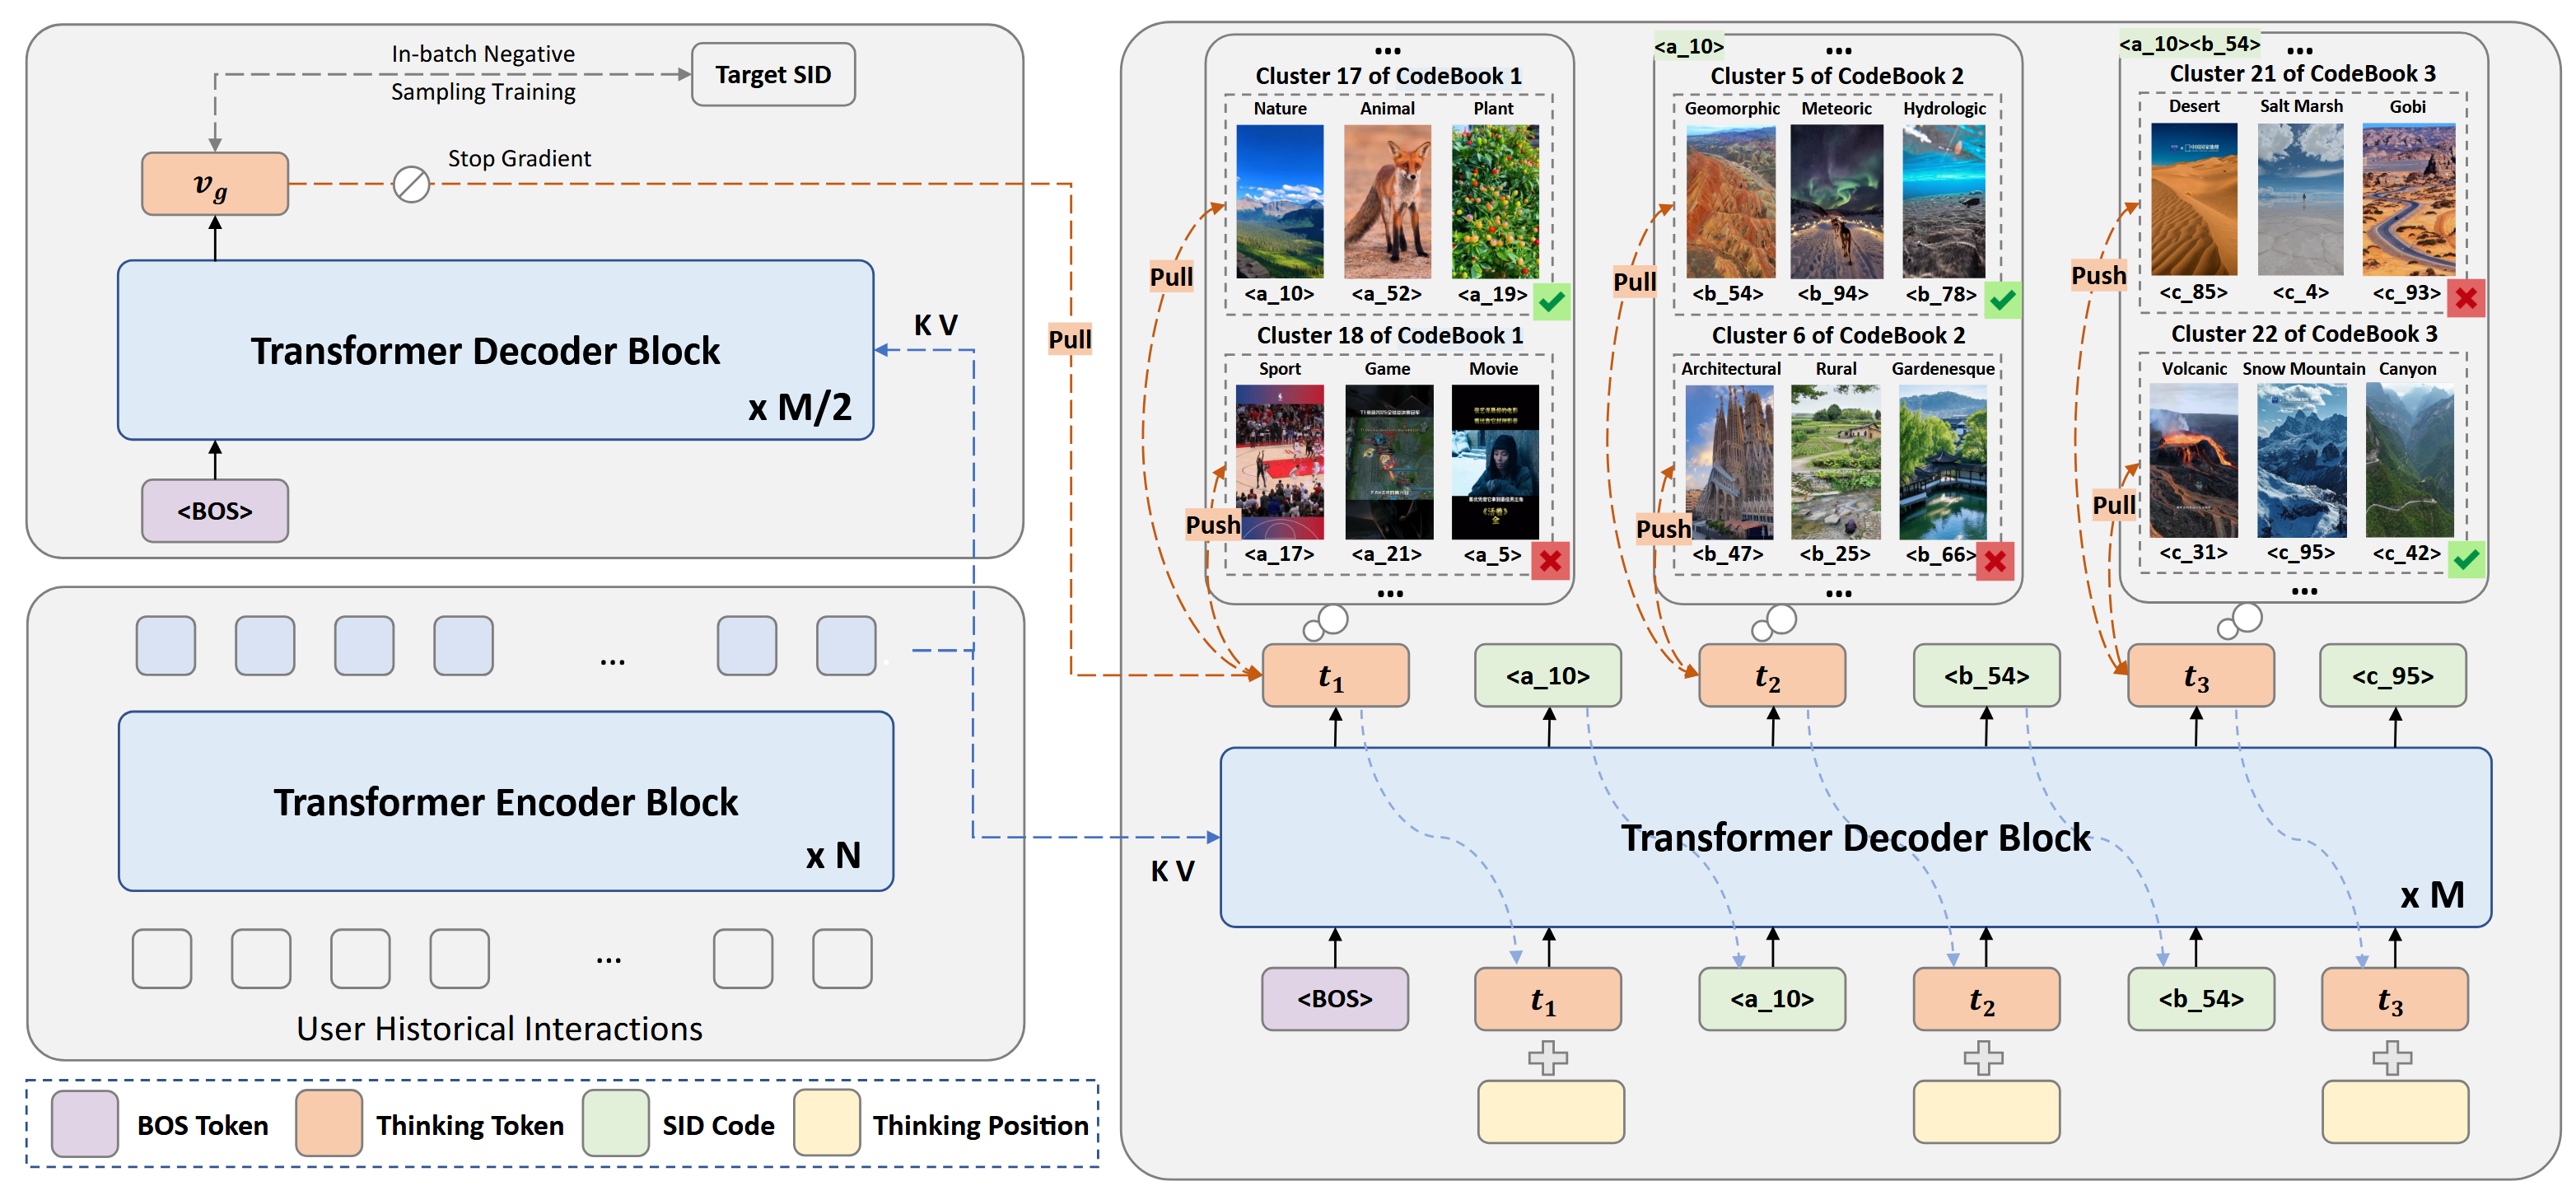
(逐位交错思考) 原本的生成序列为 $(s_1,s_2,s_3)$, S²GR 将其改为:
$$ \mathrm{BOS}\rightarrow\bm{t}_1\rightarrow s_1\rightarrow\bm{t}_2\rightarrow s_2\rightarrow\bm{t}_3\rightarrow s_3. $$每一步先根据用户历史、已生成的 SID 和 thinking 向量产生新的连续状态, 加上层级位置向量, 再将其反馈给 decoder 预测下一位 SID:
$$ \bm{t}_l=\operatorname{Decoder}_{\theta}(\mathrm{BOS},\bm{t}_1,s_1,\ldots,\bm{t}_{l-1},s_{l-1};\mathbf{H}_{\mathrm{enc}})+\bm{p}_l. $$每个 SID 位置都获得一个中间计算步骤, 后续思考也能利用已经生成的前缀.
-
(Thinking 的监督来自码本聚类) 对每层码本分别做 K-means, 将 $256$ 个码向量归入 $K_c$ 个粗粒度簇. 设目标码 $s_l^i$ 所属簇为 $g_l(s_l^i)$, thinking 向量向对应中心靠近、与其他中心区分:
$$ \mathcal{L}_{\mathrm{Align}}^{(l)}=-\frac{1}{B}\sum_{i=1}^{B}\log\frac{\exp(\operatorname{cos}(\bm{t}_l^i,\bm{c}_{l,g_l(s_l^i)})/\tau)}{\sum_{k=1}^{K_c}\exp(\operatorname{cos}(\bm{t}_l^i,\bm{c}_{l,k})/\tau)}. $$先预测粗粒度簇语义, 再预测具体码, 是这里潜在推理的具体含义. 簇来自学习到的码本空间, 并非人工标注的商品类别; 对齐损失提供软监督, 不等同于推理时强制在某个簇内解码.
-
(第一步补充整体兴趣监督) 辅助轻量 decoder 根据同一用户历史生成 $\bm{v}_g$, 用 batch 内负例的 InfoNCE 使其靠近目标 item 的整体 embedding $\overline{\bm{v}}$. 再约束:
$$ \mathcal{L}_{\mathrm{Reg}}=1-\frac{1}{B}\sum_{i=1}^{B}\operatorname{cos}(\bm{t}_1^i,\operatorname{sg}(\bm{v}_g^i)). $$这样第一步同时接受首层聚类语义与完整 item 语义的监督. 停止梯度使该正则通过 $\bm{v}_g$ 指导 $\bm{t}_1$, 辅助分支自身通过 InfoNCE 学习.
-
(训练目标) 主推荐目标仍是正确 SID 的交叉熵, 另加各步对齐与辅助兴趣监督:
$$ \mathcal{L}=\mathcal{L}_{\mathrm{Rec}}+\sum_{l=1}^{L}\mathcal{L}_{\mathrm{Align}}^{(l)}+\mathcal{L}_{\mathrm{InfoNCE}}+\lambda\mathcal{L}_{\mathrm{Reg}}. $$$\lambda$ 控制首步整体语义正则的权重. 训练阶段用目标 SID 构造监督, 预测阶段从用户历史和已生成前缀产生 thinking 向量.
关键洞察
-
(模型与数据) 主推荐模型采用 T5 架构, 包含四层 encoder 和四层 decoder, 与 TIGER 基线一致; 图示辅助 decoder 深度为主 decoder 的一半. Beauty 的 item 向量来自 Qwen3-Embedding-4B, 工业视频向量来自自有多模态模型. CoBa 沿用 RQ-VAE 的 encoder/decoder 框架, 文中未给出其具体层宽配置.
-
(计算开销) 附录在工业数据、相同参数规模、两张 A100 上报告: TIGER 训练约 $45$ 小时, S²GR 约 $59$ 小时; 推理总耗时分别约 $0.88$ 和 $0.90$ 小时. 实现中 thinking 不单独扩展 beam, 而是在各 beam 内连续完成 thinking 与后续 SID 预测. 这些数值是所测任务的总耗时, 不是单请求延迟.
-
(在线实验) TIGER 与 S²GR 两组各覆盖 $5.25\%$ 用户, 持续七天. 总使用时长提升 $0.092\%$, 人均使用时长提升 $0.088\%$, 总视频观看次数提升 $0.091\%$. 三项报告的 $95\%$ 置信区间下界均大于零.
-
(语义解释的范围) thinking 向量具有可检查的码本簇对齐目标, 其解释依赖码本的语义组织质量. 论文并未由此证明整个 SID 严格形成语义树, 或潜在向量构成人类可读的逻辑推导.
继往开来
-
将推理计算安排到每一次离散决策之前. S²GR 把额外潜在步骤与 SID 位置逐一对应, 并为每一步提供比最终编码更粗的监督目标, 使训练能够直接约束中间状态.
-
Tokenizer 同时决定生成目标与推理监督. 码本聚类既定义了 thinking 的学习目标, 也决定了这种监督的语义质量. 后续可通过前缀错误率、簇预测准确率和逐层收益, 进一步分析码本结构如何影响潜在推理.
参考文献
- Guo Z., Wang J., Zhou R., Liu Y., Guo J., Zhao J., Xu X., Liu Y. and Zhan K. S²GR: Stepwise Semantic-Guided Reasoning in Latent Space for Generative Recommendation. arXiv, 2026. [PDF]