Fast Inference from Transformers via Speculative Decoding
Content
研究背景
-
(Serial Decoding) 自回归模型生成 $K$ 个 token 需要串行执行 $K$ 次. 大模型的 decode 往往受内存带宽和通信限制, 而非算力限制: 每步都要重新读入庞大的权重, GPU 却未必没有空余计算资源.
-
(Easy Steps, Cheap Guess) 不是每个下一个 token 都同样难预测. 因此可以先让便宜的 approximation model $M_q$ 连续猜 $\gamma$ 个 token, 再把这些候选前缀交给目标模型 $M_p$ 一次性并行评估. 猜对就批量接受, 猜错则纠正第一个错误位置.
-
关键难点是: 这种加速不能只在 greedy decoding 下“差不多对”. 本文想要的保证更强: 无论 draft model $q$ 多差, 最终 token 序列的概率分布都与直接从 target model $p$ 采样完全一致.
核心思想
-
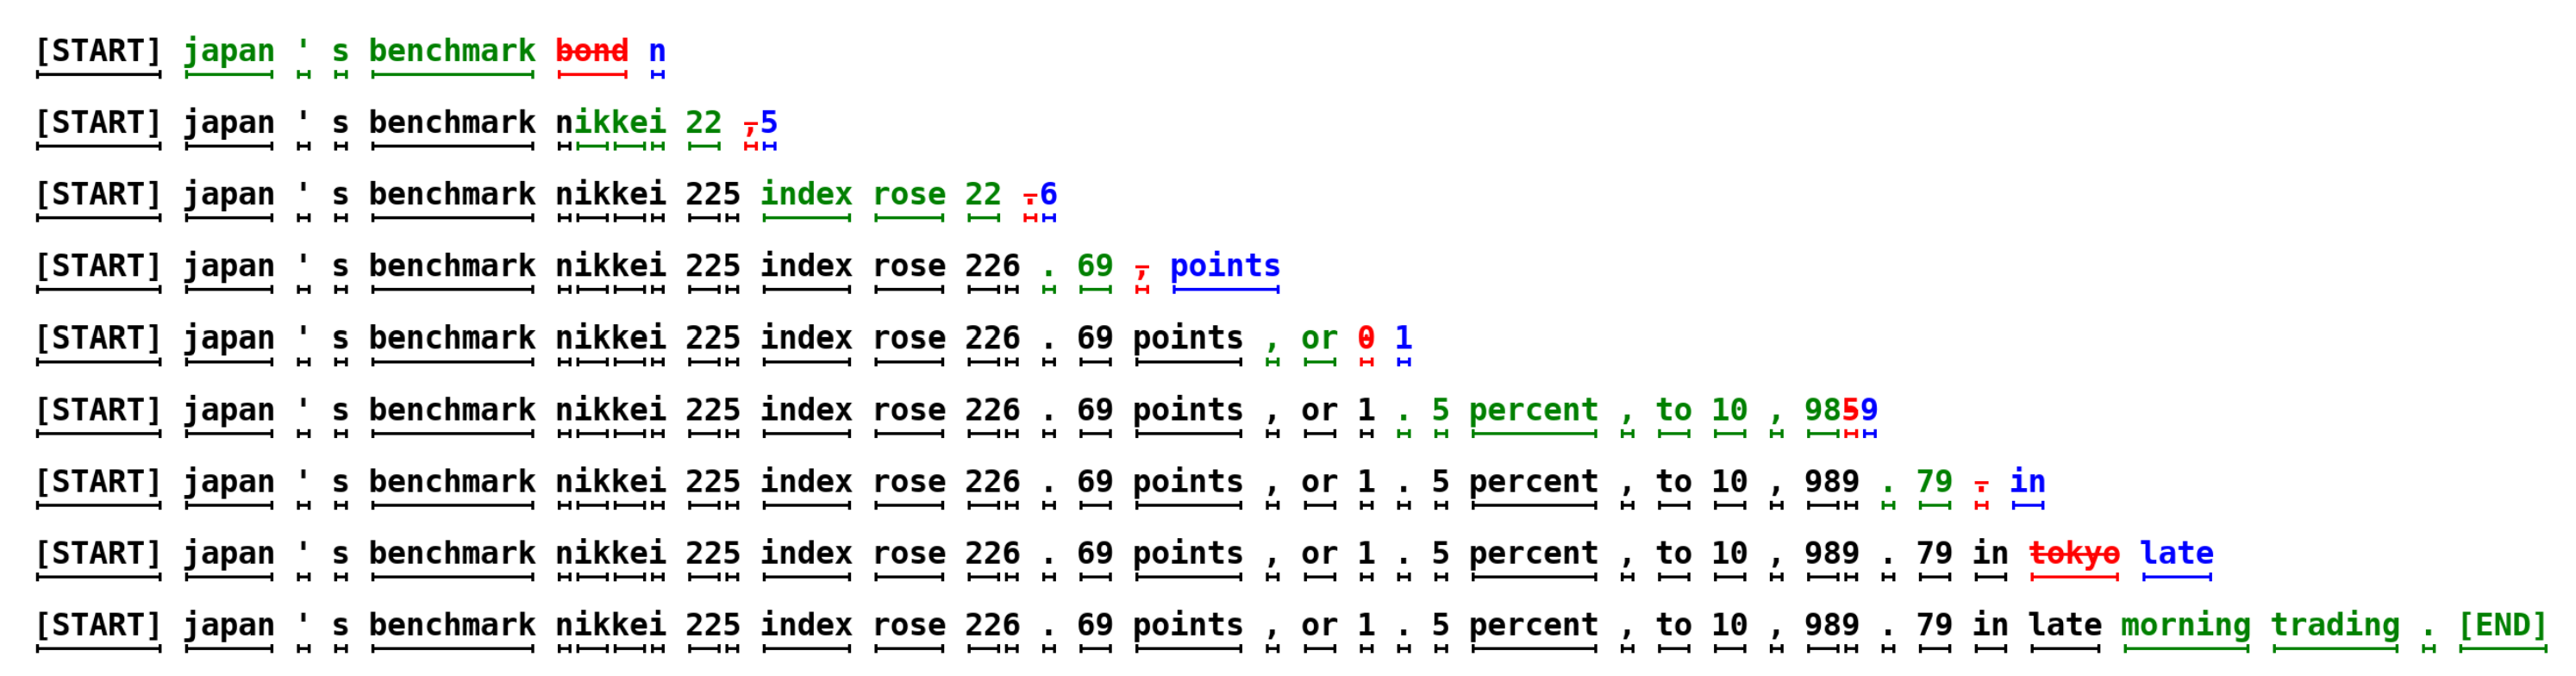
通常我们会有一个 $M_t$ 的 LLM, 生成 $k$ 个 tokens 需要 forward $k$ 次, 由于参数量过大, 推理成本是巨大的.
-
投机解码/推测解码的思路是用一个小的模型/算法 $M_q$ 进行推测, 每一次得到长度为 $\gamma$ 的序列, 然后经过 $M_t$ 进行验证.
-
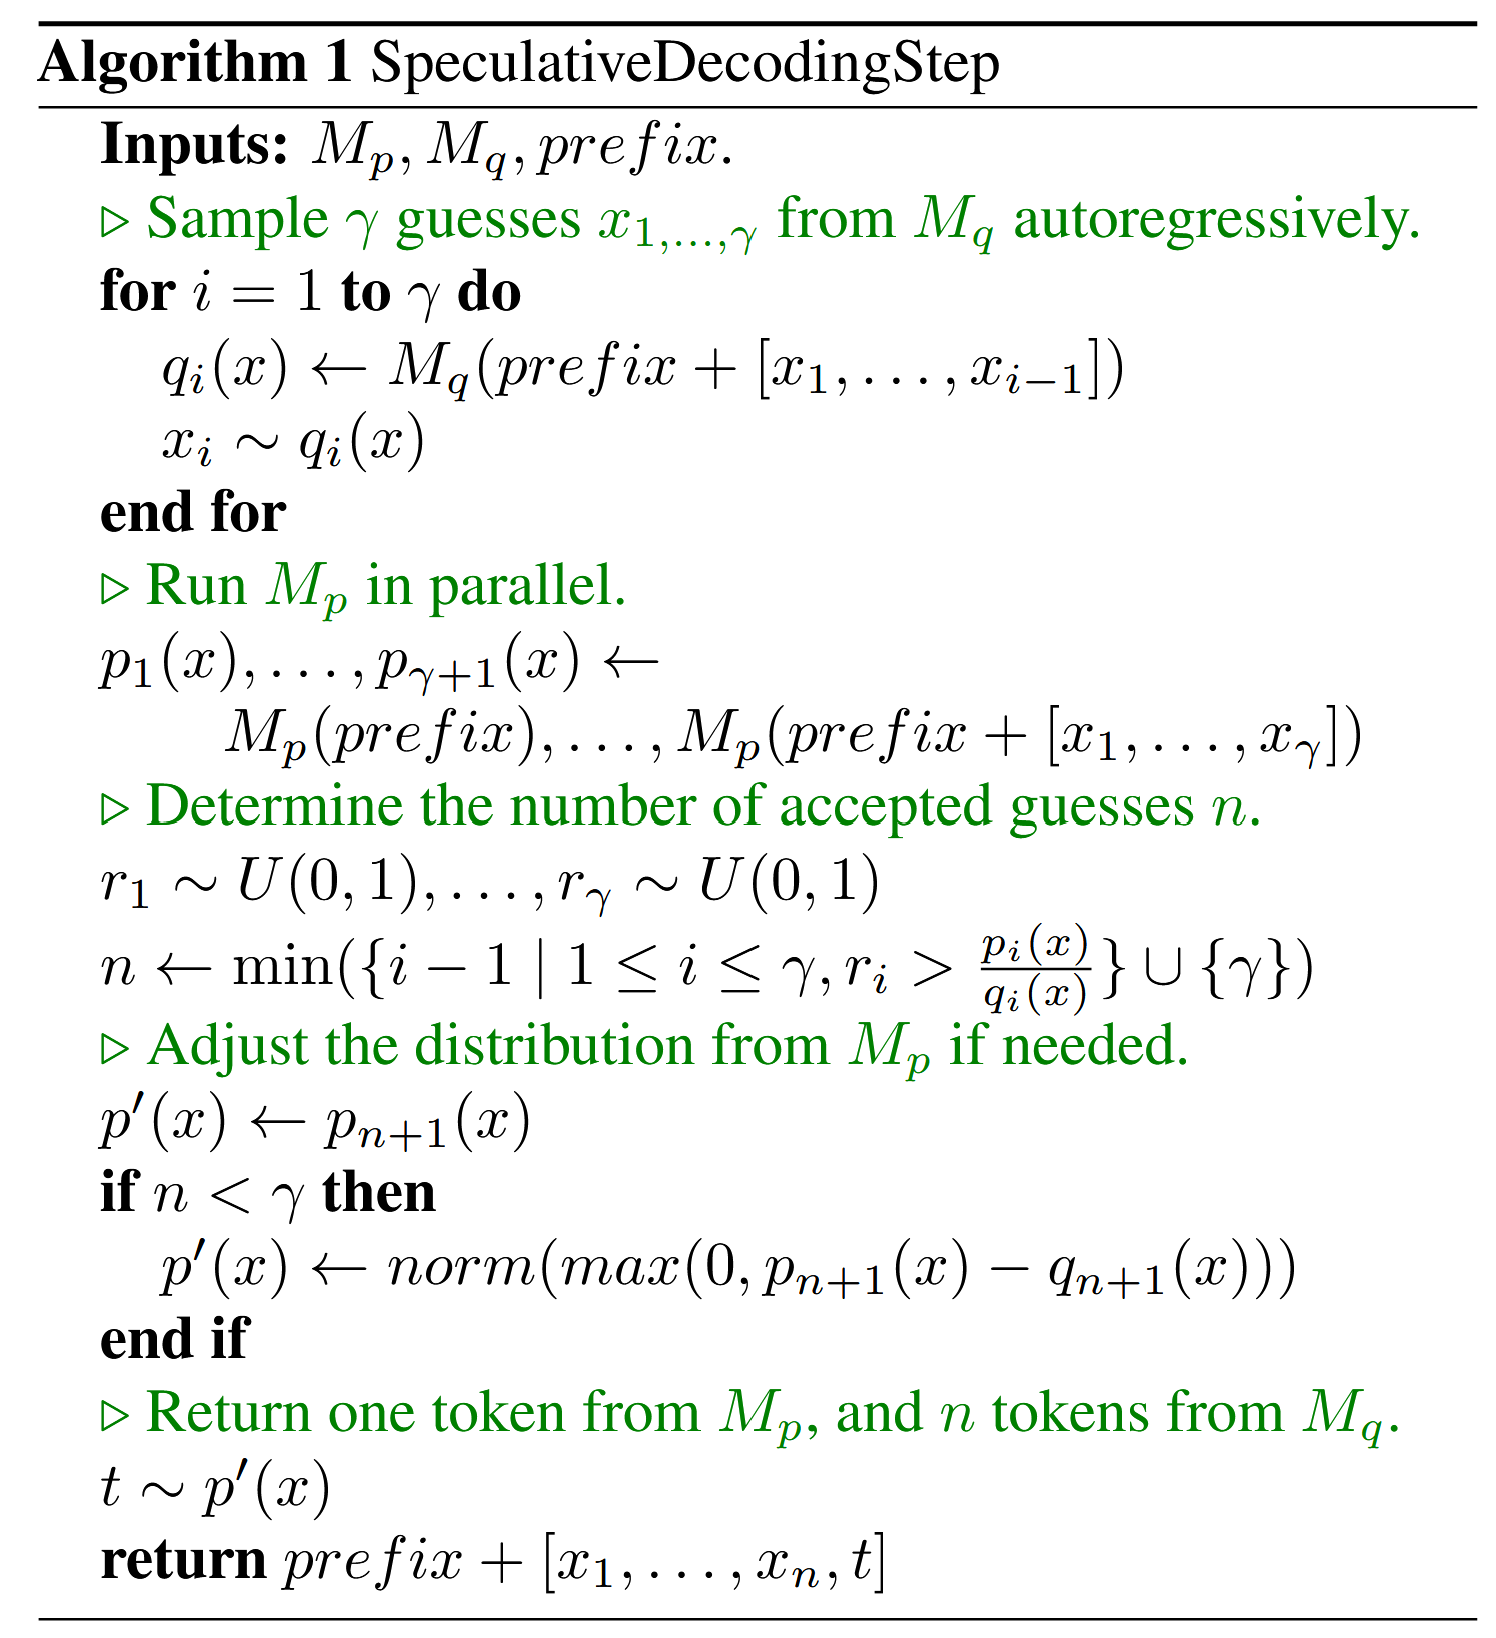
每轮先由 $M_q$ 自回归生成 $x_1, \ldots, x_\gamma$. 接着 target model 并行计算:
$$ p_1(\cdot), \ldots, p_{\gamma + 1}(\cdot) = M_p(\mathrm{prefix}), \ldots, M_p(\mathrm{prefix} + [x_1, \ldots, x_\gamma]). $$ -
随后从第一个猜测开始逐一按 speculative sampling 接受. 若第 $n + 1$ 个猜测被拒绝, 返回前 $n$ 个接受的 draft token, 再从修正后的 $p'_{n + 1}$ 补一个 target token; 若所有猜测都接受, 再从 $p_{\gamma + 1}$ 额外采一个 token. 所以每一轮至少产出一个 token, 最多产出 $\gamma + 1$ 个 token.
-
这一设计的漂亮之处是: target model 做了 $\gamma + 1$ 条并行前缀的计算, 但只需要一轮串行等待. 当硬件本就 memory-bound 时, 更多并发计算可以换来更低 latency; 反过来, 若算力已经饱和, 这套方法就未必划算. 此外, 根据下面的推理, 投机解码概率上等价于从原模型中进行采样.
Speculative Sampling: 理论基础
-
对某个 prefix, 令 $p(x)$ 和 $q(x)$ 分别是 target 和 draft 的、已经应用 temperature/top-k/top-p 等规则后的标准化分布. 先采样 $x \sim q(x)$:
- 若 $q(x) \leq p(x)$, 直接接受;
- 若 $q(x) > p(x)$, 以 $p(x) / q(x)$ 的概率接受;
- 若拒绝, 则从 target 的剩余分布中采样:
-
对于 $X \in \Omega$, 可以分成这样两种情况进行分析:
- $X \in \Omega_- := \{x: q(x) > p(x)\}$, 则
- $X \in \Omega_+ := \{x: q(x) \le p(x)\}$, 则
- GPT 给出的证明方案:
先只考虑生成一个 token. 令 draft proposal 为 $q(x)$.
-
从 $q$ 采样候选 $y$.
-
以如下概率接受:
因此, 最终“候选正好是 $x$ 且被接受”的概率为:
$$ \mathbb{P}(\mathrm{accept}, y = x) = q(x)a(x) = q(x)\min\left(1, \frac{p(x)}{q(x)}\right) = \min(p(x), q(x)). $$这正是两分布的重叠概率质量.
候选被拒绝的总概率为:
$$ Z = 1 - \sum_x \min(p(x), q(x)) = \sum_x \max(0, p(x) - q(x)). $$拒绝后不直接从 $p$ 重采样, 而是从 target 尚未被“接受分支”覆盖的残差分布采样:
$$ p'(x) = \frac{\max(0, p(x) - q(x))}{Z}. $$于是最终输出为 $x$ 的概率是两条路径之和:
$$ \begin{align*} \mathbb{P}(\mathrm{output} = x) &= \mathbb{P}(\mathrm{accept}, y = x) +\mathbb{P}(\mathrm{reject}) p'(x) \\ &= \min(p(x), q(x)) +Z \cdot \frac{\max(0, p(x) - q(x))}{Z} \\ &= \min(p(x), q(x)) + p(x) - \min(p(x), q(x)) \\ &= p(x). \end{align*} $$如何确定单次生成长度 $\gamma$
-
令 $\beta(h)$ 为某一位置 draft token 被接受的概率, 并用独立同分布近似其平均值 $\alpha = \mathbb{E}[\beta]$. 则一次 speculative decoding step 的期望生成 token 数为:
$$ \mathbb{E}[\#\mathrm{tokens}] = \frac{1 - \alpha^{\gamma + 1}}{1 - \alpha}. $$ -
$\alpha$ 也可以写成两个分布的重叠度. 论文定义 $D_{\mathrm{LK}}(p, q)$, 并得到:
$$ \alpha = 1 - D_{\mathrm{LK}}(p, q) = \sum_x \min(p(x), q(x)). $$这让 draft model 的好坏不再只是“参数更小/更大”, 而是 $p$ 与 $q$ 的实际分布是否重叠.
-
(代价) 因此, 投机解码其实并不存在采样偏差, 其代价就是, 如果代理模型 $M_q$ 和 目标模型 $M_t$ 差别过大, 会导致一个较大的拒绝率, 反而可能导致成本增加.
-
令 $c$ 为 draft 单步耗时与 target 单步耗时之比. 在 target 的并发验证不增加 wall time 的理想条件下, 期望加速为:
$$ \mathrm{Speedup} = \frac{1 - \alpha^{\gamma + 1}} {(1 - \alpha)(\gamma c + 1)}. $$ -
更大的 draft 通常提高 $\alpha$, 也提高 $c$; 更长的 speculative block 增加潜在产出, 也增加 draft 开销和浪费计算. 因此文章建议直接根据实测的 $\alpha$ 与 $c$ 数值搜索 $\gamma$, 而不是固定用某个经验长度.
关键洞察
-
(Exactness is the point) 这篇工作最大的价值是把“用小模型省算力”改成了“用小模型增加并发, 再用概率修正保持 target distribution”. 它不需要改 target architecture、不需要重训, 也不以改变输出分布换速度. 这为后续大量 draft、tree 和 self-speculation 方法提供了共同的正确性基线.
-
(速度来自降低 memory access, 不是减少 FLOPs) 猜错的分支会浪费算术操作; 论文明确指出总运算量可能增加. 但 target 权重与 KV cache 可以由一次并行验证复用, 读取次数随每轮接受 token 数下降. 所以它最适合 memory-bandwidth bottleneck 且有额外算力的场景.
-
(T5-XXL 的实证结果) 在单 TPU-v4、batch size $1$ 上, 以 T5-XXL ($11$B) 为 target、T5-small ($77$M) 为 draft, 英德翻译达到 $3.4\times$ (argmax) 和 $2.6\times$ (standard sampling) 加速; CNN/DailyMail 摘要达到 $3.1\times$ 和 $2.3\times$. T5-base/large 的接受率更高, 但自身成本更高, 未必更快.
-
(小 draft 也可能有用) 文中甚至发现 bigram draft 在英德翻译上有约 $0.2$ 的接受率. 因其相对成本近似为零, 使用 $\gamma = 3$ 仍可取得约 $1.25\times$ 加速. 这提醒我: speculative decoding 的 draft 不是“越强越好”, 而是“分布重叠 / 成本”比值要高.
继往开来
-
这篇论文基本奠定了今天 speculative decoding 的标准范式. 后续像 SEQUOIA 之类的方法, 本质上都在两个方向上继续推进: 如何把多次猜测组织得比单链更有效, 以及如何在不同采样配置下让接受率更稳健.
-
论文的速度公式依赖两个重要近似: 各位置接受事件近似 i.i.d., 且 $\gamma + 1$ 条 target 前缀可以几乎等时并行完成. 前者在复杂上下文中未必成立, 后者受模型、KV cache、batching 和硬件限制. 因而真实部署应直接测量 end-to-end latency, 而不是只用 acceptance rate 推断收益.
-
我认为一个非常实际的工程原则是: 把“精确”和“加速”分别验收. 先用概率校验或确定性测试确认实现没有破坏目标分布, 再针对不同 batch size、上下文长度和服务负载调 draft、$\gamma$ 与 cache 策略. 只报单请求加速, 很容易掩盖吞吐或尾延迟上的代价.
参考文献
- Leviathan Y., Kalman M. and Matias Y. Fast Inference from Transformers via Speculative Decoding. ICML, 2023.