Tokenize Once, Recommend Anywhere: Unified Item Tokenization for Multi-domain LLM-based Recommendation
Content
研究背景
-
(统一 Item Tokenization) TIGER 等方法使用 RQ-VAE 将 item 内容向量转为离散 Semantic ID. 当业务覆盖多个商品类别或服务域时, 分别训练 tokenizer 会重复存储编码器、解码器和码本; 直接混合各域训练同一个 tokenizer, 又可能忽略域间分布与语义差异.
-
(UniTok) 本文希望训练一个可跨域复用的 tokenizer, 同时保留共享信息与域特有信息. Tokenizer 的训练使用 item 内容, 不依赖用户交互或跨域共享用户; 下游推荐模型仍使用交互序列学习用户偏好.
-
(符号说明)
- $K$: 训练域数量, 同时作为域专家数量; 实验取 $K=10$.
- $\bm{x}_i^k \in \mathbb{R}^{d}$: 第 $k$ 个域中 item $i$ 的内容向量.
- $f_{\theta},g_{\phi}$: 共享编码器与解码器; $\bm{z}_i^k=f_{\theta}(\bm{x}_i^k)$ 为连续潜在表示.
- $E_e,E_{\mathrm{share}}$: 第 $e$ 个路由专家与始终激活的共享专家.
- $G_e(\bm{z})$: 路由器分配给专家 $e$ 的概率; $N$: 每个 item 选择的路由专家数.
- $L$: 每个专家的残差量化层数; $T$: 每层码本大小.
- $\mathcal{C}_{e,\ell}$: 专家 $e$ 在第 $\ell$ 层的码本; $\bm{c}_{e,\ell}$: 选中的码向量.
- $\widehat I_k$: 第 $k$ 个域的输入与潜在表示之间的 HSIC 依赖度, 用作互信息的代理量.
核心思想
-
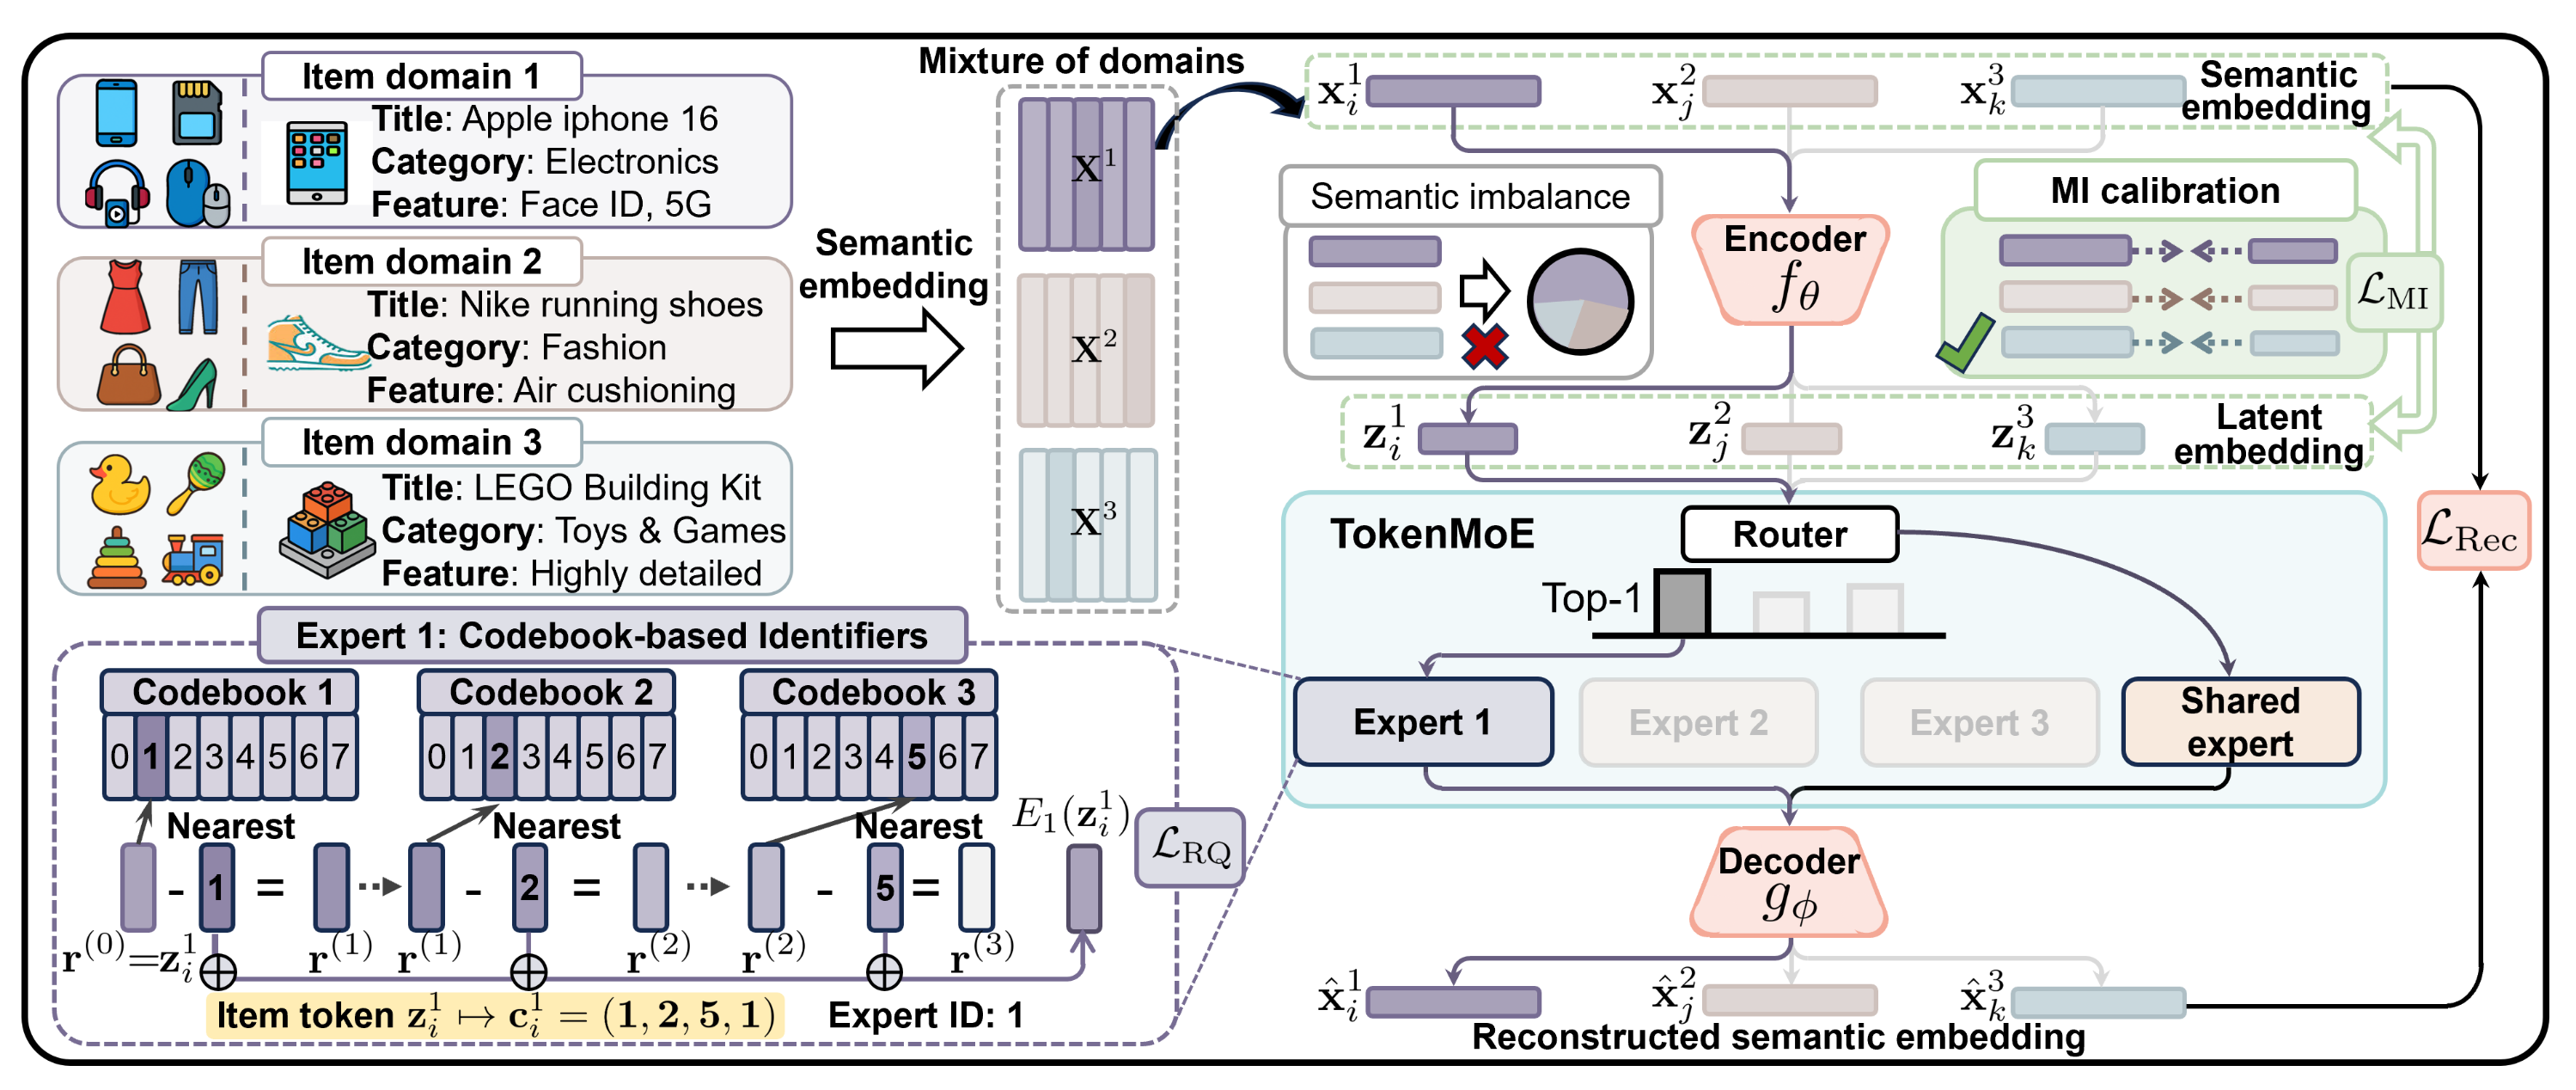
(共享编码器 + 专家量化) 所有域先通过共享编码器进入统一潜在空间. TokenMoE 再根据潜在表示选择 Top-$N$ 个专家, 同时激活共享专家, 将量化结果相加后送入共享解码器:
$$ \bm{G}(\bm{z})=\operatorname{softmax}(h(\bm{z})), \qquad \widehat{\bm{z}}=\sum_{e \in \operatorname{TopN}(\bm{G}(\bm{z}))}G_e(\bm{z})E_e(\bm{z})+E_{\mathrm{share}}(\bm{z}), \qquad \widehat{\bm{x}}=g_{\phi}(\widehat{\bm{z}}). $$其中 $h$ 为可学习的线性路由器. 专家是不同的量化码本组, MoE 位于 tokenizer 内部. 路由依据输入学习, 并非根据域标签固定分配. 作者使用各域平均特征初始化对应专家, 用跨域平均特征初始化共享专家, 引入域相关的初始化偏置.
-
(专家内部的残差量化) 每个专家对输入潜在表示逐层量化. 令 $\bm{r}_{e,0}=\bm{z}$, 则:
$$ \bm{c}_{e,\ell}=\arg\min_{\bm{c} \in \mathcal{C}_{e,\ell}}\|\bm{r}_{e,\ell-1}-\bm{c}\|_2^2, \qquad \bm{r}_{e,\ell}=\bm{r}_{e,\ell-1}-\bm{c}_{e,\ell}, \qquad E_e(\bm{z})=\sum_{\ell=1}^{L}\bm{c}_{e,\ell}. $$共享专家也采用残差量化. 码本学习与 commitment 项共同约束选中的码向量及其对应连续表示.
-
(离散 ID 包含专家身份) 原文式 (7) 将 item ID 记为 $(z_1,\ldots,z_L,e_1,\ldots,e_N)$, 其中 $z_{\ell}$ 表示量化索引, $e_n$ 表示选中的专家 ID. 专家身份参与标识, 使不同专家中的码本索引能够区分. 该式简写了多个专家的输出, 未展开共享专家及 Top-$N$ 多组量化索引的完整序列化方式.
-
(域间信息校准) 共享编码器可能对部分域保留较多信息, 对另一些域保留较少信息. 作者以 HSIC 衡量每个域中输入 $\mathbf{X}_k$ 与潜在表示 $\mathbf{Z}_k$ 的依赖程度:
$$ \widehat I_k=\widehat{\operatorname{HSIC}}(\mathbf{X}_k,\mathbf{Z}_k)=\frac{\operatorname{Tr}(\mathbf{U}_k\mathbf{H}_k\mathbf{V}_k\mathbf{H}_k)}{(n_k-1)^2}. $$这里 $n_k$ 为参与计算的域内样本数, $\mathbf{U}_k,\mathbf{V}_k$ 分别是输入与潜在表示的高斯核矩阵, $\mathbf{H}_k=\mathbf{I}-\mathbf{1}\mathbf{1}^{\top}/n_k$ 为中心化矩阵. HSIC 是依赖性度量, 本文将其作为互信息代理, 并非直接计算互信息.
校准目标同时降低域间差异、提高整体依赖程度:
$$ \mathcal{L}_{\mathrm{MI}}=\operatorname{Var}_{k}[\widehat I_k]-\beta\operatorname{Mean}_{k}[\widehat I_k]. $$方差项鼓励不同域保留相近程度的信息, 均值项避免仅通过共同降低依赖程度来取得平衡, $\beta$ 控制二者权重.
-
(训练与推荐衔接) 总目标由重建损失、残差量化损失和信息校准损失组成:
$$ \mathcal{L}=\mathcal{L}_{\mathrm{Rec}}+\lambda_{\mathrm{RQ}}\mathcal{L}_{\mathrm{RQ}}+\lambda_{\mathrm{MI}}\mathcal{L}_{\mathrm{MI}}, \qquad \mathcal{L}_{\mathrm{Rec}}=\sum_{k,i}\|\bm{x}_i^k-\widehat{\bm{x}}_i^k\|_2^2. $$$\lambda_{\mathrm{RQ}},\lambda_{\mathrm{MI}}$ 为损失权重. 先训练统一 tokenizer, 再将交互历史转换为 item token 序列, 由 T5 推荐模型学习预测下一个交互 item 的 token. 统一 tokenizer 与下游序列推荐是两个训练阶段.
关键洞察
-
(实验设置) 在 Amazon 的九个类别及 Yelp 共十个域上训练统一 tokenizer, 与各域独立训练的基线比较. 默认采用四层量化, 每层 $256$ 个 $32$ 维码向量, $\lambda_{\mathrm{RQ}}=1$, $\lambda_{\mathrm{MI}}=0.03$. 推荐使用 full-ranking 评价, 候选为用户未交互的全部 item.
-
(推荐效果) 下表摘录 Table 1 的 NDCG@10, 基线列为该数据集表现最好的比较方法:
数据集 最佳基线 UniTok 相对提升 Beauty 0.0381 0.0478 25.46% Cellphones 0.0473 0.0647 36.78% Toys 0.0291 0.0442 51.89% Games 0.0469 0.0476 1.49% Yelp 0.0231 0.0321 38.96% 十个域均有提升, 幅度差异较大. 表格中的最大 NDCG@10 提升来自 Toys; 正文一处将其写为 Tools, 与表格不一致.
-
(参数效率的来源) 十个独立 tokenizer 的累计参数量为 $87.78$M, UniTok 为 $9.11$M, 相差约 $9.63$ 倍. 主要节省来自 autoencoder 从累计 $87.45$M 降至共享的 $8.75$M. 该比较衡量多域 tokenizer 的总存储与训练参数规模, 不对应单次推荐推理的加速倍数.
-
(共同训练的对照) 将 TIGER、LC-Rec 和 LETTER 的 tokenizer 也改为十域联合训练、使用近似参数预算后, 基线表现下降. Cellphones 上最佳基线 Recall@10 为 $0.0678$, UniTok 为 $0.1251$, 相对提升 $84.51\%$. 这一对照支持专家划分对混合域量化的作用.
-
(新域泛化) 训练好的 tokenizer 直接用于未见的 Clothing、Health 和 Sports, 不再训练或微调 tokenizer. Health 的 NDCG@10 从最佳基线的 $0.0375$ 提升至 $0.0442$, 相对提升 $17.87\%$. 这一实验验证 tokenizer 的跨域复用能力; 文中未据此建立整个推荐模型无需目标域训练的结论.
继往开来
-
将统一性放在 tokenizer 接口上. UniTok 用共享 autoencoder 降低多域重复建模成本, 用专家码本保留分布差异, 为跨域复用 Semantic ID 构造器提供了具体方案.
-
平衡对象从编码占用扩展到各域的信息保留. 信息校准关注某个域是否在共享表示中被弱化, 与码本使用是否均衡属于不同问题. 后续可进一步分析域间依赖度、编码结构与推荐可学习性之间的关系.