HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation
Content
研究背景
-
(Semantic ID) TIGER 等生成式推荐方法先通过 RQ-VAE 将商品表示为多级离散编码, 再根据用户历史或查询自回归生成下一件商品的 SID. 前面的编码决定粗粒度分支, 后面的编码进一步区分商品.
-
(训练监督) 普通交叉熵 (CE) 对各个 SID 位置使用相同权重, 商品获得的监督量也随训练频次而变化. HASTE 从这两点出发, 用层级损失强调粗层决策, 用目录属性补充长尾商品的语义监督.
-
(符号说明)
- $x$: 用户历史、查询或对话上下文;
- $\bm{s}_i=(s_{i,0},s_{i,1},s_{i,2},s_{i,3})$: 商品 $i$ 的 SID, 层索引统一为 $0,1,2,3$;
- $L_0,L_1,L_2$: 三个残差量化层, 每层 $256$ 个 code; $L_3$: 附加的去重编码, 区分前三层编码相同的商品;
- $\ell_{i,l}=-\log P_{\theta}(s_{i,l}\mid x,s_{i,
- $w_l,\tilde w_{i,l}$: 第 $l$ 层的基础权重与样本相关的有效权重.
核心思想
-
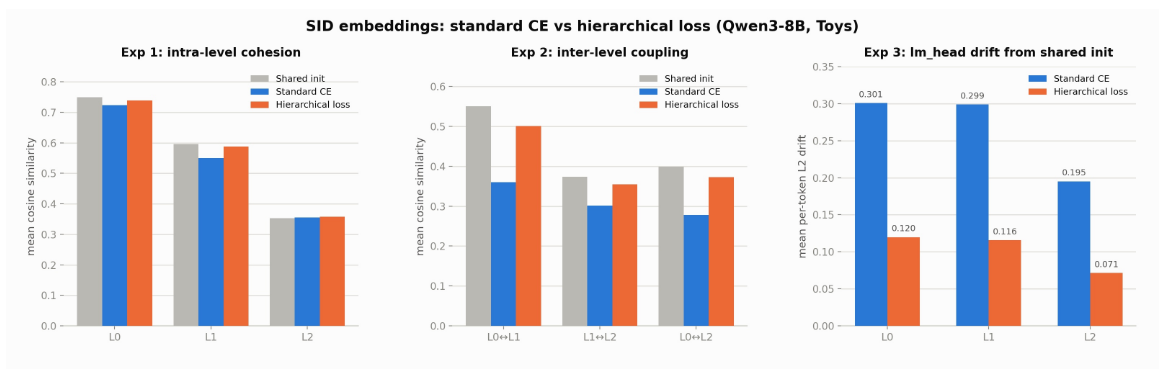
(动机一: 微调时保留 SID 的层级结构) Figure 2 从同一个初始化出发, 对比普通 CE 与层级损失 (Hierarchical Loss, HL) 训练后的 SID embeddings:
- 同层聚合 (a): HL 下的粗层 $L_0$ 表示保持了更高的组内相似性.
- 跨层联系 (b): $L_0$ 与 $L_1$ 输出 embeddings 的平均余弦相似度从初始化的 $0.55$ 降至 CE 下的 $0.36$, HL 下则为 $0.50$.
- 表示漂移 (c): 以每个 token 的 embedding 相对初始化的欧氏距离衡量变化, HL 的漂移约为 CE 的 $1/2$ 到 $1/4$.
这组观察支持作者的设计思路: 训练目标也应体现 SID 从粗到细的结构. 粗层预测决定后续生成所在的分支, 因此应先强调粗层决策, 再根据前缀的可靠程度调整细层监督.
-
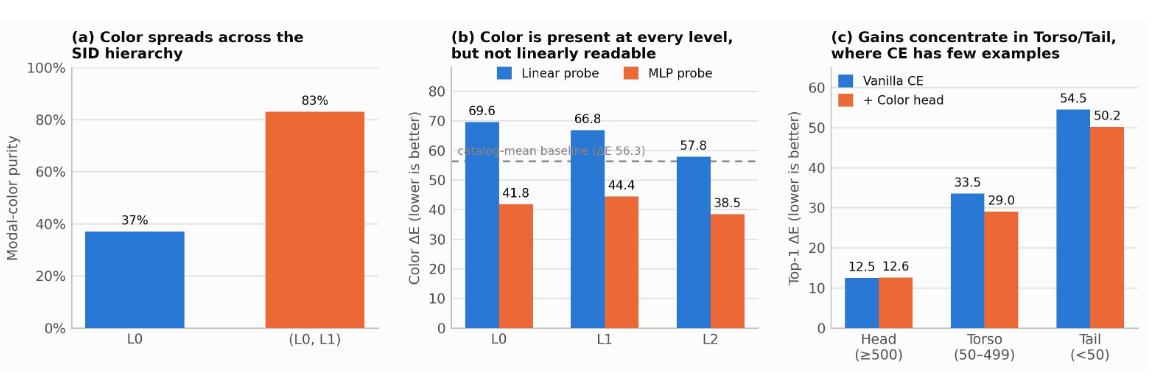
(动机二: 为长尾商品补充属性监督) SID 根据商品的整体语义构造, 而用户还会关注颜色、材质等具体属性. Figure 3 以颜色为例, 说明为什么需要单独的属性目标:
- 属性随层级逐步细化 (a): 按 $L_0$ 分组时的颜色纯度为 $37\%$, 按 $(L_0,L_1)$ 前缀分组时提高到 $83\%$. 前缀越具体, 组内商品的颜色越一致.
- 属性信息适合用非线性映射提取 (b): 冻结模型后训练颜色预测探针, MLP 明显优于线性映射. 在预测 $L_2$ 的位置, MLP 的颜色误差 $\Delta E$ 为 $38.5$, 低于直接预测目录平均颜色的 $56.3$. $\Delta E$ 表示颜色空间中的距离, 越小越好.
- 额外监督主要帮助低频组 (c): 加入颜色监督后, 中频与低频颜色组的 top-1 颜色误差分别从 $33.5$ 降至 $29.0$、从 $54.5$ 降至 $50.2$, 高频组基本持平.
因此, HASTE 在预测 $L_2$ 的隐状态上接入 MLP 属性头, 用商品目录中的颜色或材质作为标签. 每次学习生成 SID 时, 同时学习恢复商品属性, 从而为属性交互稀疏的商品提供更密集的监督.
-
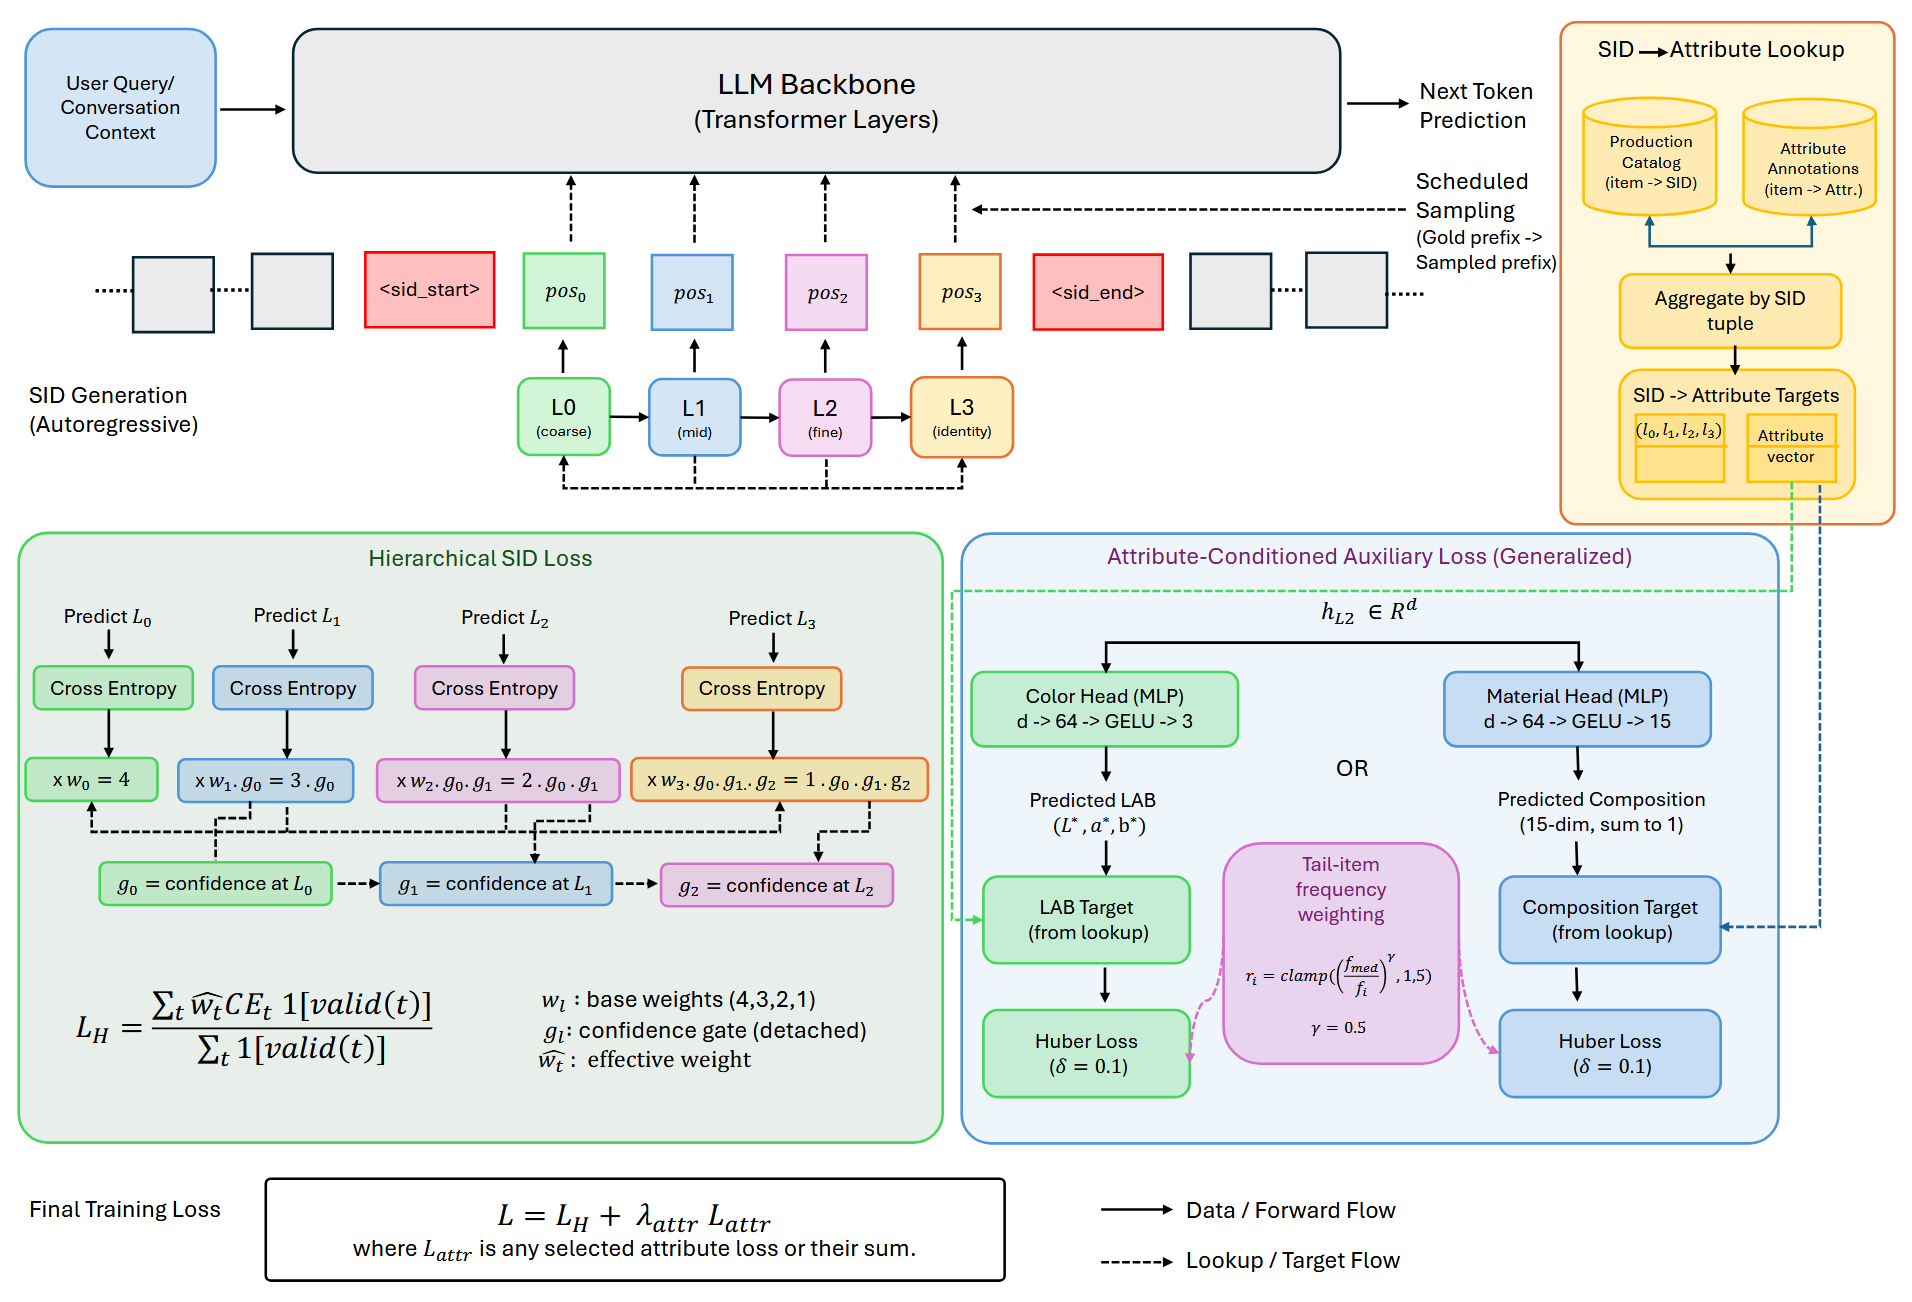
(整体框架) HASTE 在 Qwen3-8B 上扩展 SID 词表, 先训练新 token embeddings, 再联合微调语言模型与属性头:
$$ \mathcal L_{\mathrm{HASTE}}=\mathcal L_{\mathrm{hier}}+\lambda_{\mathrm{attr}}\mathcal L_{\mathrm{attr}}. $$$\lambda_{\mathrm{attr}}$ 控制辅助监督强度. 层级损失调整各层 SID 的学习重点, 属性损失让预测表示保留商品属性. 推荐时仍按原流程生成 SID.
-
(第一步: 粗层使用更大的基础权重) 对四个 SID 位置设置:
$$ (w_0,w_1,w_2,w_3)=(4,3,2,1). $$同样大小的预测误差, 在粗层对应更大的损失, 让模型优先学好决定生成分支的前缀.
-
(第二步: 用上游置信度调节下游监督) 令模型对当前位置正确 token 的预测概率为 $P_{i,l}^{\mathrm{correct}}$, 定义停止梯度的置信度:
$$ c_{i,l}=\operatorname{stopgrad}\left[\max\left(P_{i,l}^{\mathrm{correct}},\epsilon\right)^{\gamma}\right], \qquad g_{i,l}=\prod_{k < l}c_{i,k}, \qquad g_{i,0}=1. $$$\epsilon=0.2$ 为置信度下限, $\gamma=1$ 控制幂次; $\operatorname{stopgrad}$ 表示计算梯度时将该权重视为常数. $g_{i,l}$ 汇总当前位置之前的预测置信度: 前缀越可靠, 细层监督权重越高; 前缀不确定时, 降低细层权重, 保留更多学习重点给上游决策.
-
(第三步: 从静态权重逐渐过渡到置信度门控) 训练早期的置信度不可靠, 因此让混合系数 $\alpha$ 从 $1$ 线性降到 $0$:
$$ \tilde w_{i,l}=w_l\left[\alpha+(1-\alpha)g_{i,l}\right]. $$初始使用 $4:3:2:1$ 的静态权重, 随后逐渐引入置信度门控. 例如, 当 $\alpha=0$, 前两层置信度分别为 $0.5$、$0.8$ 时, $L_2$ 的有效权重为 $2\times0.5\times0.8=0.8$; 当前缀置信度接近 $1$ 时, 权重接近基础值 $2$.
最终将加权交叉熵按有效标签位置取平均:
$$ \mathcal L_{\mathrm{hier}}=\frac{\sum_t\tilde w_t\ell_t\,\mathbb{1}[\operatorname{valid}(t)]}{\sum_t\mathbb{1}[\operatorname{valid}(t)]}. $$$t$ 遍历训练序列中的标签位置, $\ell_t$ 为该位置的交叉熵, $\mathbb{1}[\operatorname{valid}(t)]$ 标记参与训练的有效标签. SID token 使用对应层的有效权重, 其余 token 的权重为 $1$.
-
(第四步: 用 scheduled sampling 学习应对错误前缀) Teacher forcing 使用真实 SID 前缀, 推理时则依赖模型自己生成的前缀. 为缩小这一差异, 训练时先做一次无梯度前向计算, 从最粗层的预测分布采样 token, 以概率 $p_{\mathrm{ss}}$ 替换输入中的真实 code, 再用替换后的输入计算置信度与损失. 随着训练推进, 逐渐提高替换概率, 让模型学习在自己生成的前缀下继续预测.
-
(属性头: 从细层预测表示恢复商品属性) 取最后一层 Transformer 中用于预测 $L_2$ 的隐状态 $\bm h_{L_2}\in\mathbb{R}^{d}$, 此时模型已经读入 $L_0,L_1$, 实验中 $d=4096$. 对属性 $a$ 添加一个输出维度为 $d_a$ 的两层 MLP:
$$ \hat{\bm y}_i^a=\mathbf W_a^{(2)}\operatorname{GELU}\left(\mathbf W_a^{(1)}\bm h_{L_2}+\bm b_a^{(1)}\right)+\bm b_a^{(2)}. $$其中 $\mathbf W_a^{(1)}\in\mathbb{R}^{64\times4096}$, $\mathbf W_a^{(2)}\in\mathbb{R}^{d_a\times64}$, 两个偏置分别为 $64$ 维与 $d_a$ 维. 隐状态先压缩到 $64$ 维, 经 GELU 后再映射为属性预测 $\hat{\bm y}_i^a\in\mathbb{R}^{d_a}$.
目录标签 $\bm{y}_i^a$ 通过商品 SID 查询得到, 具体构造如下:
- 颜色 ($d_a=3$): 使用归一化的 CIELAB 向量, 三个分量分别为明度 $L$ 和两个颜色轴 $a^*,b^*$.
- 材质 ($d_a=15$): 将原始描述解析为 $14$ 类纤维加 other 的组成比例, 保留明确百分比, 分配剩余比例后归一化, 各分量之和为 $1$. 例如, “80% 棉、20% 聚酯纤维” 对应这两维分别为 $0.8$、$0.2$, 其余维度为 $0$.
属性头使用 Huber 回归损失, 转折阈值 $\delta=0.1$:
$$ \mathcal L_a=\operatorname{Huber}_{0.1}(\hat{\bm y}_i^a,\bm y_i^a). $$标签直接来自商品目录, 因此即使当前对话没有提及颜色或材质, 也能计算属性损失, 并将梯度传回生成 SID 的语言模型.
-
(颜色监督进一步关注低频样本) 以 $f_i$ 表示样本对应的训练频次, $f_{\mathrm{med}}$ 为中位频次, 对颜色损失乘上权重:
$$ r_i=\operatorname{clip}\left[\left(\frac{f_{\mathrm{med}}}{f_i}\right)^{0.5},1,5\right]. $$高频样本的权重为 $1$, 低频样本最多放大到 $5$ 倍. 这样, 目录属性既增加了监督来源, 又通过频次加权加强了对长尾的关注.
关键洞察
-
(SID 构造) RQ-VAE encoder 为 $1024\rightarrow512\rightarrow256\rightarrow128\rightarrow32$, 使用三个大小为 $256$ 的残差码本, 再附加去重 code. Amazon Sports、Beauty、Toys 主要使用文本内容, Internal-fashion 使用多模态商品表示. HASTE 在得到 SID 后改进语言模型的训练目标.
-
(训练配置) 置信度门控的 $\alpha$ 在 $300000$ 个优化步骤内从 $1$ 降至 $0$; scheduled sampling 的 $p_{\mathrm{ss}}$ 在 $200000$ 步内从 $0$ 增至 $0.3$. 颜色监督系数为 $\lambda_{\mathrm{color}}=0.1$, 频次加权在实现中按 $L_2$ code 统计; 材质监督系数为 $\lambda_{\mathrm{material}}=1.0$, 所有材质样本使用相同的回归损失权重.
-
(属性监督的收益主要在尾部) Fashion-140k 包含 $141300$ 个商品, 属性由处理后的目录和 Gemini 提取结果提供; Internal-fashion 有 $163724$ 个商品. Table 2 中, HL 基础上再加入属性监督的尾部 Recall@10 为:
方法 Fashion-140k tail Internal-fashion tail CE 0.0169 0.0342 HL 0.0215 0.0387 HL + Color 0.0267 0.0456 HL + Material 0.0258 0.0447 以 HL 为基线, 颜色监督分别提高 $24.2\%$ 和 $17.8\%$, 材质监督分别提高 $20.0\%$ 和 $15.5\%$. 层级监督改善 SID 学习之后, 属性监督仍能进一步提升长尾商品的推荐效果.
继往开来
-
Guided SID 将任务属性引入粗层编码的构造, HASTE 则在已有 SID 上加入层级课程与属性辅助任务. 两者分别从编码构造和生成模型训练出发, 让语义结构更好地服务于推荐.
-
HASTE 将训练监督分成两个互补目标: 层级损失分配各个 SID 位置的学习重点, 属性损失为预测表示提供直接的语义约束. 对具有层级编码和商品属性的生成式推荐任务, 可以沿着这两个方向设计训练目标.
参考文献
- Shukla T., Somasundaram S., Gupta A., Garg R., Duff P. and Anderson I. HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation. arXiv, 2026. [PDF]