Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
Content
研究背景
-
(独立 draft model 的成本) 投机解码 让小模型提前生成候选, 再用大模型并行验证, 减少昂贵的串行调用. 但合适的小模型不一定现成可用, 还需要额外训练、部署和维护; 小模型本身也要逐 token 生成 draft.
-
(Medusa 的切入点) 大模型当前的 hidden state 已经包含丰富的上下文信息, 能否直接据此预测多个未来位置? Medusa 在原模型上增加几个轻量预测头, 用它们替代独立 draft model, 再通过候选树提高一次验证的有效产出.
-
(符号说明) 给定前缀 $x_{1:t}$, $h_t$ 是 backbone 的最后一层 hidden state. 原 LM head 输出 $p_t^{(0)}$, 预测 $x_{t+1}$; 第 $k$ 个 Medusa head 输出 $p_t^{(k)}$, 预测 $x_{t+k+1}$, 其中 $k=1,\ldots,K$.
核心思想
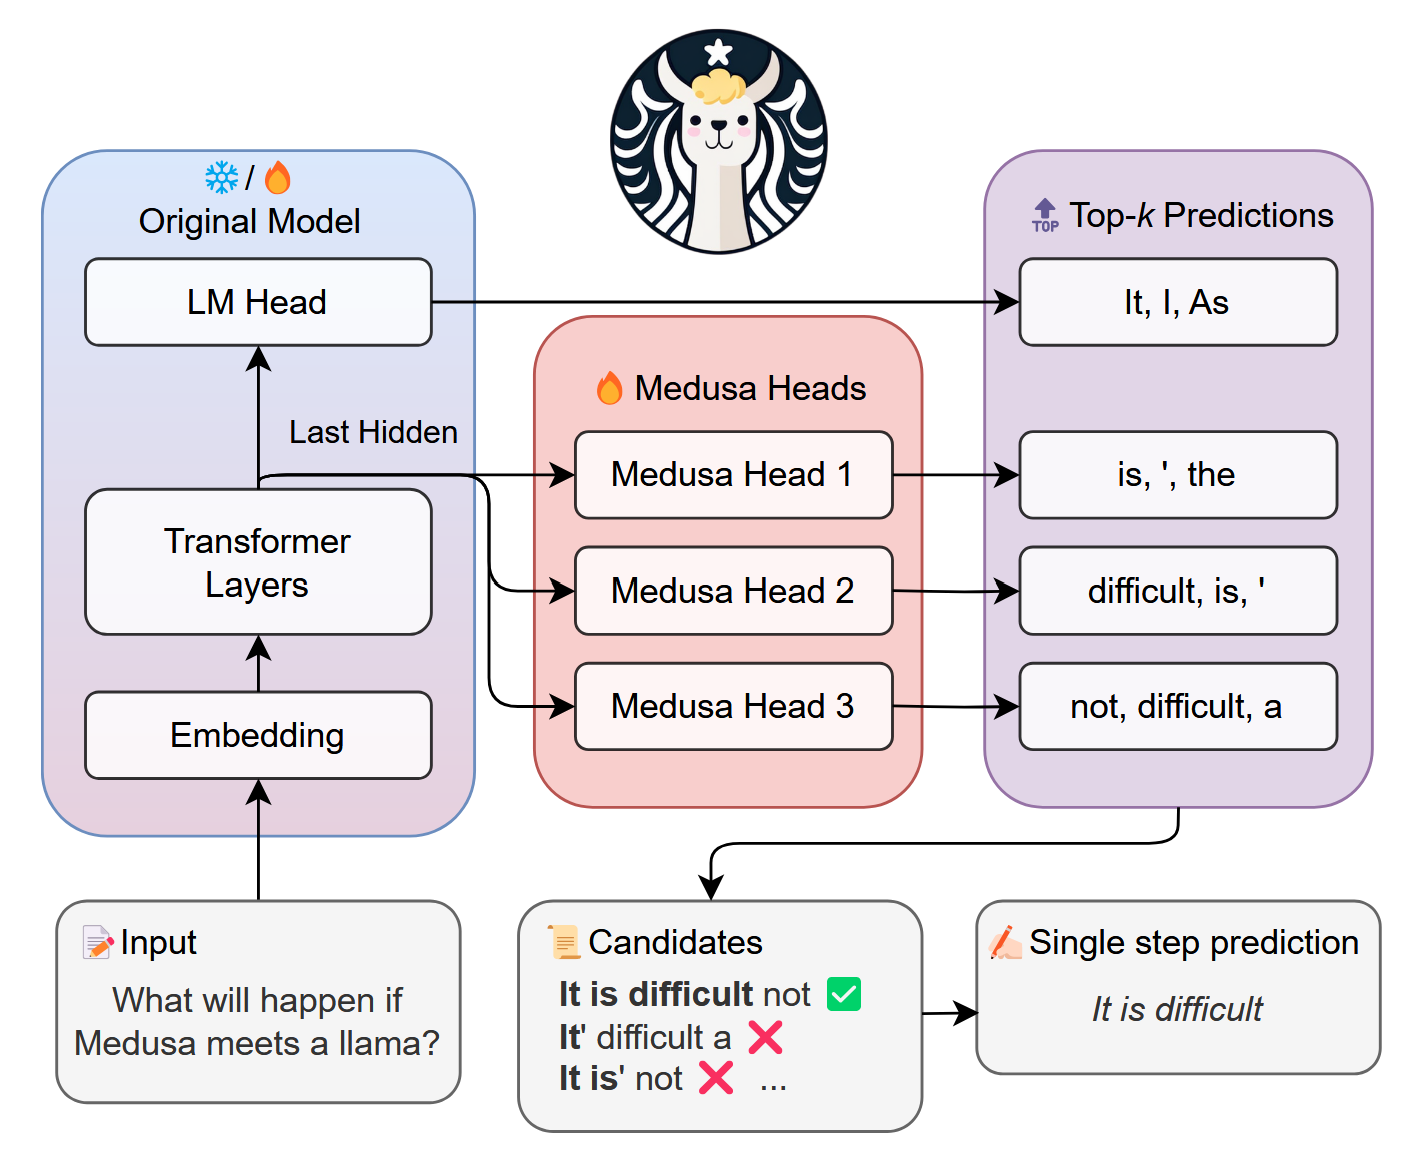
Medusa 的关键不是让多个头直接替代自回归生成, 而是将它们作为低成本的并行候选生成器. 整体仍遵循生成候选、验证候选、接受前缀的流程.
1. 多个预测头: 从同一个状态预测不同未来位置
-
(头部结构) 每个 head 使用一层带残差连接的前馈网络, 再投影到词表:
$$ \tag{1} p_t^{(k)}
\operatorname{softmax}\left( W_2^{(k)} \left[h_t+\operatorname{SiLU}(W_1^{(k)}h_t)\right] \right). $$
初始化时, $W_1^{(k)}=0$, $W_2^{(k)}$ 复制原 LM head 的参数. 各头最初与原 LM head 给出相同预测, 再通过训练学习不同的预测跨度.
-
(并行而非串行) 所有头都读取同一份 $h_t$, 不需要等前一个头生成 token 后再运行. 例如原 LM head 预测下一词, head 1 预测再下一词, head 2 预测第三词. head 2 不会将 head 1 的候选作为条件输入, 因而远期预测更不确定, 各头拼出的序列也未必彼此协调. 这正是需要后续验证的原因: heads 提供可能的未来 token, backbone 再根据实际候选前缀计算条件概率.
2. 候选树: 将多头预测组合后一次验证
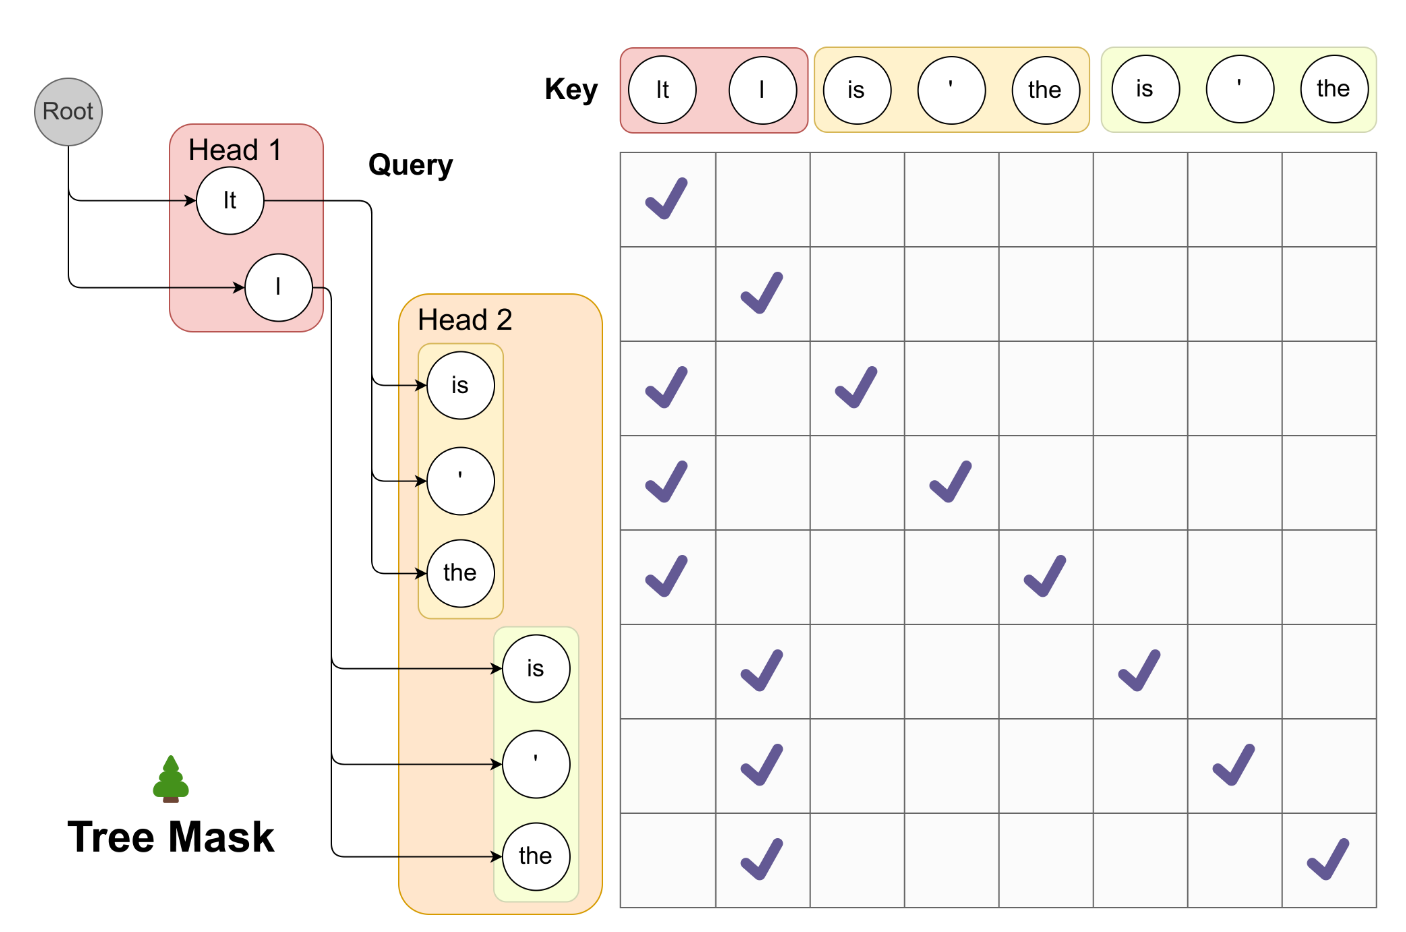
-
(构造候选) 先由原 LM head 确定第一枚 token $r$. 对第 $k$ 个 Medusa head, 取其 top-$s_k$ 预测作为该位置的候选. 最简单的方式是对各头候选做笛卡尔积, 得到多条后续路径. 例如 head 1 给出 $\{A,B\}$, head 2 给出 $\{C,D\}$, 则形成 $rAC,rAD,rBC,rBD$ 四条路径. 第二层的 C、D 来自同一份 head 2 预测, 但放到不同路径后需要分别验证, 因为真实条件分布 $p(\cdot\mid x_{1:t},r,A)$ 和 $p(\cdot\mid x_{1:t},r,B)$ 不同.
-
(树状并行计算) 将共享前缀的路径组织为树, 展开为节点列表. 通过 tree attention mask, 每个节点只关注输入前缀、自身及路径上的祖先, 位置编码按路径深度设置. 这样可以用一次 backbone forward 计算整棵树的条件分布, 而不必将每条路径复制成独立序列. 验证某个候选 token 时, 使用的是父节点的原 LM head 输出, 而不是提出它的 Medusa head 分数. 例如验证 C 在路径 $rAC$ 中是否合理, 使用 A 节点输出的 $p(\cdot\mid x_{1:t},r,A)$.
-
(控制树的大小) 完整笛卡尔积会快速膨胀. 固定第一枚 token $r$ 后, Medusa 候选节点数为
$$ \sum_{k=1}^{K}\prod_{i=1}^{k}s_i. $$因此实际可以使用稀疏树, 只保留更有希望的组合, 不必让每个位置拥有相同分支数. 原论文还给出了基于校准准确率的树形选择方法, 见后文.
3. 接受候选: 严格验证与 typical acceptance
-
(严格模式) 若希望保持原模型的 greedy 输出, 就逐位置检查候选是否等于 backbone 在该路径下的 argmax, 只接受连续匹配的前缀. 若希望保持随机采样的目标分布, 则需要与候选生成过程匹配的正确拒绝采样机制, 不能仅凭候选概率较高就接受.
-
(Typical acceptance) 为进一步提高接受长度, 论文提出放宽验证: 不要求候选恰好是 target 本次采样或 greedy 选择的 token, 只要求它在真实条件分布下足够合理. 对候选 $y$ 及其路径前缀 $c$, 接受条件为
$$ \tag{2} p(y\mid c)
\min\left( \epsilon,, \delta\exp[-H(p(\cdot\mid c))] \right). $$
$\epsilon$ 是固定阈值, $\delta$ 调节熵相关阈值. 当分布熵较高, 合理的后续选择较多, $\exp(-H)$ 较小, 接受条件相应放宽.
-
(推进一轮) 在论文描述的 typical acceptance 流程中:
- 第一枚 token $r$ 由原 LM head greedy 选出, 无条件接受, 保证每轮至少前进一步.
- 对每条候选路径, 依次检查其余 token, 遇到第一个不满足条件的位置即停止.
- 选择最长的已接受前缀作为本轮输出.
- 保留该路径的 KV cache, 丢弃其他分支; 利用最后一个已接受节点的 hidden state 和各头输出, 构造下一轮候选.
Typical acceptance 是质量与速度的折中, 不保证输出分布严格等于原模型. 它与冻结或联合训练 backbone 是两个不同维度的选择.
4. Medusa-1/2: 如何训练预测头
-
(Medusa-1: 冻结 backbone) 只训练新增 heads. 在位置 $t$, 第 $k$ 个 head 的监督目标是实际序列中的 $x_{t+k+1}$:
$$ \tag{3} \mathcal{L}_{\mathrm{Medusa\text{-}1}}
-\sum_{k=1}^{K}\lambda_k \log p_t^{(k)}(x_{t+k+1}). $$
训练时再对有效位置取平均. 远期预测更难, 论文用 $\lambda_k=0.8^k$ 降低较远 heads 的权重. 原 backbone 不变, 训练成本低, 也可以用量化 backbone 提供 hidden states.
-
(Medusa-2: 联合训练) 为让 hidden states 更适合多位置预测, 同时更新 backbone 和 heads, 并保留原 next-token loss:
$$ \tag{4} \mathcal{L}_{\mathrm{Medusa\text{-}2}}
\underbrace{-\log p_t^{(0)}(x_{t+1})}{\mathcal{L}{\mathrm{LM}}} + \lambda_0\mathcal{L}_{\mathrm{Medusa\text{-}1}}. $$
为避免新增 heads 初期的大梯度破坏已有能力, 使用 heads warmup、较小的 backbone 学习率, 并控制辅助损失的权重. Vicuna-7B/13B 实验先训练 Medusa-1, 再以其为初始化进行联合训练; 附录中 heads 的学习率为 backbone 的 4 倍.
两者的取舍是: Medusa-1 保持原 backbone 参数, 更易部署; Medusa-2 改善预测准确率和速度, 但原模型已经发生变化, 能力是否保留需要评测, 而非分布不变的理论保证.
关键洞察
-
(稀疏树按预测收益分配预算) 在校准集上估计第 $k$ 个 head 的第 $i$ 名候选准确率 $a_k^{(i)}$, 注意它是该名次本身的命中率, 不是累计 top-$i$ accuracy. 在独立性近似下, 路径 $[i_1,\ldots,i_k]$ 的分数为
$$ f(i_1,\ldots,i_k)=\prod_{j=1}^{k}a_j^{(i_j)}. $$从当前树的可扩展节点中, 反复加入分数最高者, 直到用完预算. 这使候选集中于较高概率的组合. Figure 4 中, 64 节点的稀疏树比部分 256 节点的稠密树产生更高的每轮产出. 该选择依赖校准统计和独立性近似, 不是对任意真实上下文的最优保证.
-
(没有原始训练数据时使用自蒸馏) 用公开数据的 prompts 请求目标模型生成回答, 再训练 heads. 对 Medusa-2, 仅拟合生成文本可能损害 backbone 能力, 论文进一步用原模型分布作为 teacher, 对 backbone 使用 $\mathrm{KL}(p_{\mathrm{original}}^{(0)}\|p_{\mathrm{current}}^{(0)})$. 使用 LoRA 时, 关闭 adapter 即可得到 teacher, 不必常驻两份完整 backbone.
-
(收益来自多个环节) 论文 Table 3 汇总的加速约为: 仅 Medusa-1 heads $1.5\times$, 加入 tree attention 后 $1.9\times$, 优化树形后 $2.2\times$, 采用 Medusa-2 后 $2.8\times$. 这些是逐步叠加配置的结果, 不是可相乘的独立收益.
-
(端到端结果) 主要评测使用 MT-Bench, 关注 batch size 1, 基线为默认 Hugging Face 解码实现. Figure 3 与 Table 1 的代表性结果如下:
| 模型 | Medusa-1 加速 | Medusa-2 加速 | Medusa-2 MT-Bench 得分及相对原模型变化 |
|---|---|---|---|
| Vicuna-7B | $2.18\times$ | $2.83\times$ | $6.18\ (+0.01)$ |
| Vicuna-13B | $2.33\times$ | $2.83\times$ | $6.43\ (-0.14)$ |
| Vicuna-33B | 未列出 | $2.35\times$ | $7.18\ (+0.05)$ |
| Zephyr-7B | 未列出 | $2.66\times$ | $7.25\ (-0.07)$ |
质量由 GPT-4 评分. 这些结果支持测试任务上质量大致保持, 不意味着每种任务均无损, 更不意味着 typical acceptance 保持精确采样分布.
-
(每轮产出不等于实际加速) 论文的 acceleration rate 指每轮平均生成 token 数, overhead 指相对普通解码的单轮延迟, 两者满足
$$ \mathrm{Speedup}
\frac{\mathrm{Acceleration\ rate}}{\mathrm{Overhead}}. $$
例如 Medusa-2 Vicuna-7B 的每轮产出为 $3.47$, overhead 为 $1.22$, 实际加速约 $2.83\times$. 树继续增大时, 更多矩阵计算可能抵消接受长度的收益; 大 batch 或长上下文下也不能直接外推同样的加速倍数.
继往开来
-
Medusa 的重要转变是复用大模型已有表示, 用轻量多头并行产生 draft. 它省去独立小模型的串行生成与部署成本, 但也引入了远期预测缺少中间 token 条件的问题. 候选树与验证正是为弥补这一缺陷服务.
-
与 SEQUOIA 相比, Medusa 的主线是候选生成器与 backbone 的整合, 树形优化是提高有效产出的配套手段. 阅读时应分别看待三个指标: heads 的预测准确率、单轮验证的有效长度、包含验证开销后的 wall-clock speedup.
参考文献
- Cai T., Li Y., Geng Z., Peng H., Lee J. D., Chen D. and Dao T. Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads. ICML, 2024. [PDF]