An Efficient Private GPT Never Autoregressively Decodes
Content
研究背景
-
(Private Inference) 客户端不希望泄露输入, 服务端不希望公开模型权重. 安全两方计算 (2PC) 让双方联合执行推理, 通常结合同态加密 (HE) 与多方计算 (MPC) 协议处理线性和非线性运算. 但逐 token 解码会反复支付密码学计算、数据传输和多轮通信的成本.
-
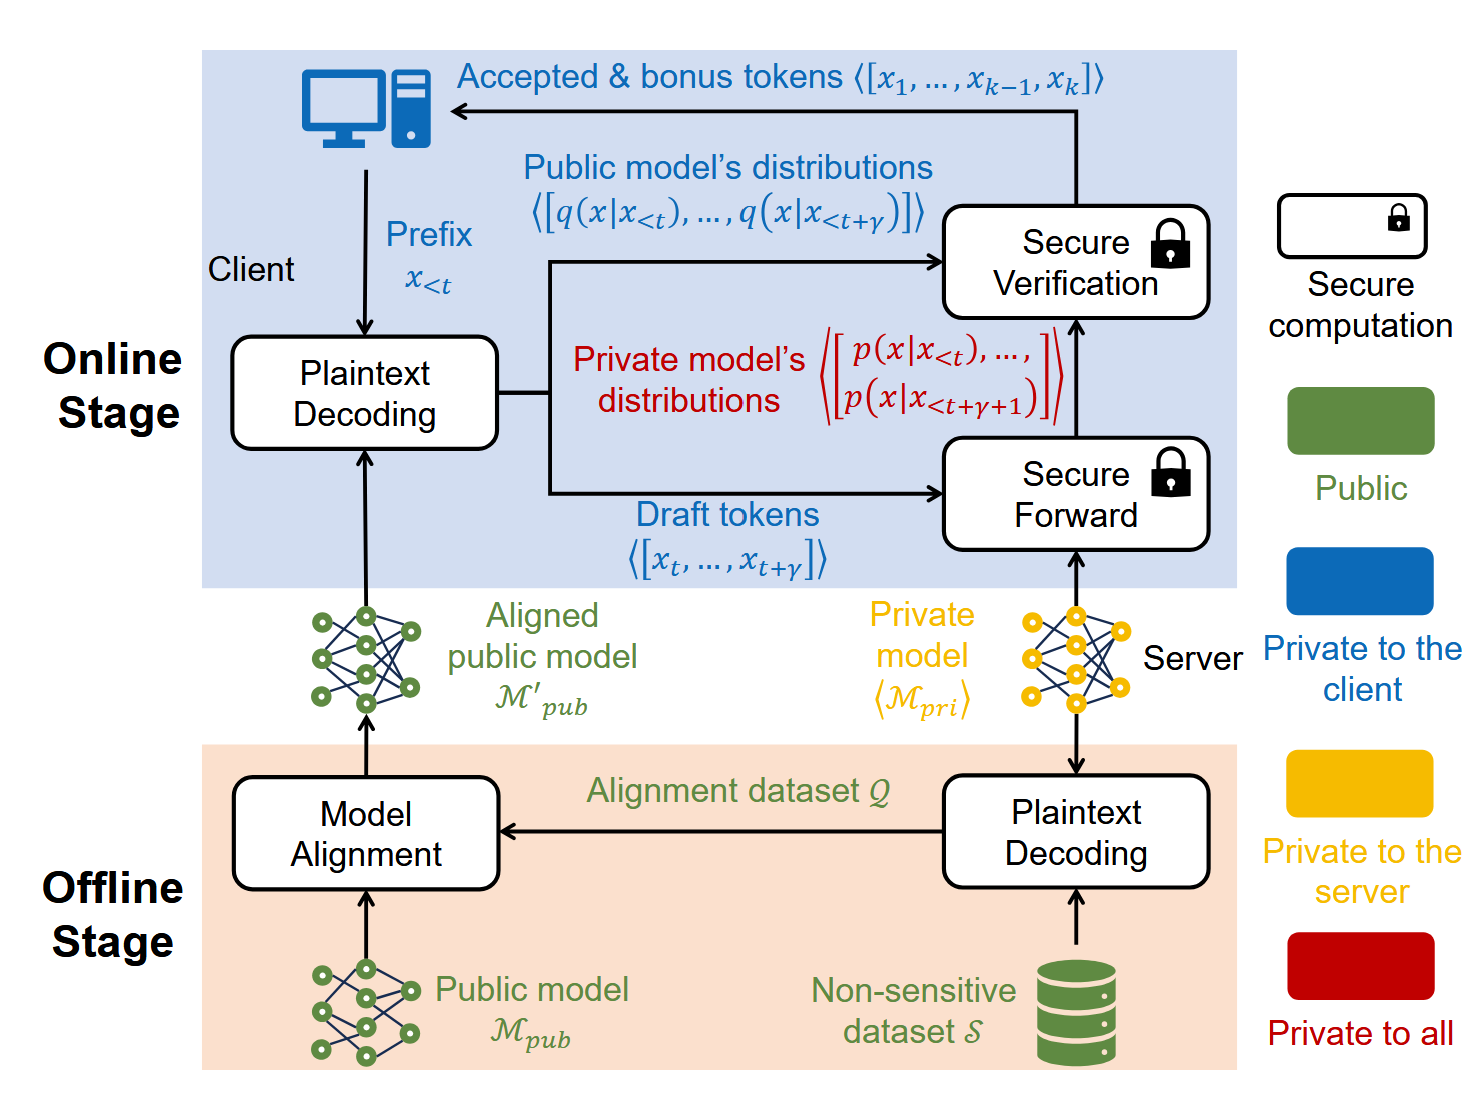
(投机解码的机会) Speculative Decoding 用便宜的小模型起草, 再由目标模型并行验证. POST 将这一思路用于隐私推理: 客户端在本地用公开模型明文起草, 私有模型通过安全计算批量验证. 公开的是模型, 客户端的输入和草稿并不因此公开给服务端.
-
(符号说明) $q_i$ 为公开草稿模型在第 $i$ 个位置的条件分布, $p_i$ 为私有目标模型在同一前缀下的条件分布, $\gamma$ 为草稿长度, $V$ 为词表大小. 安全计算中的中间量以秘密份额表示, 单方无法直接恢复其真实值.
核心思想
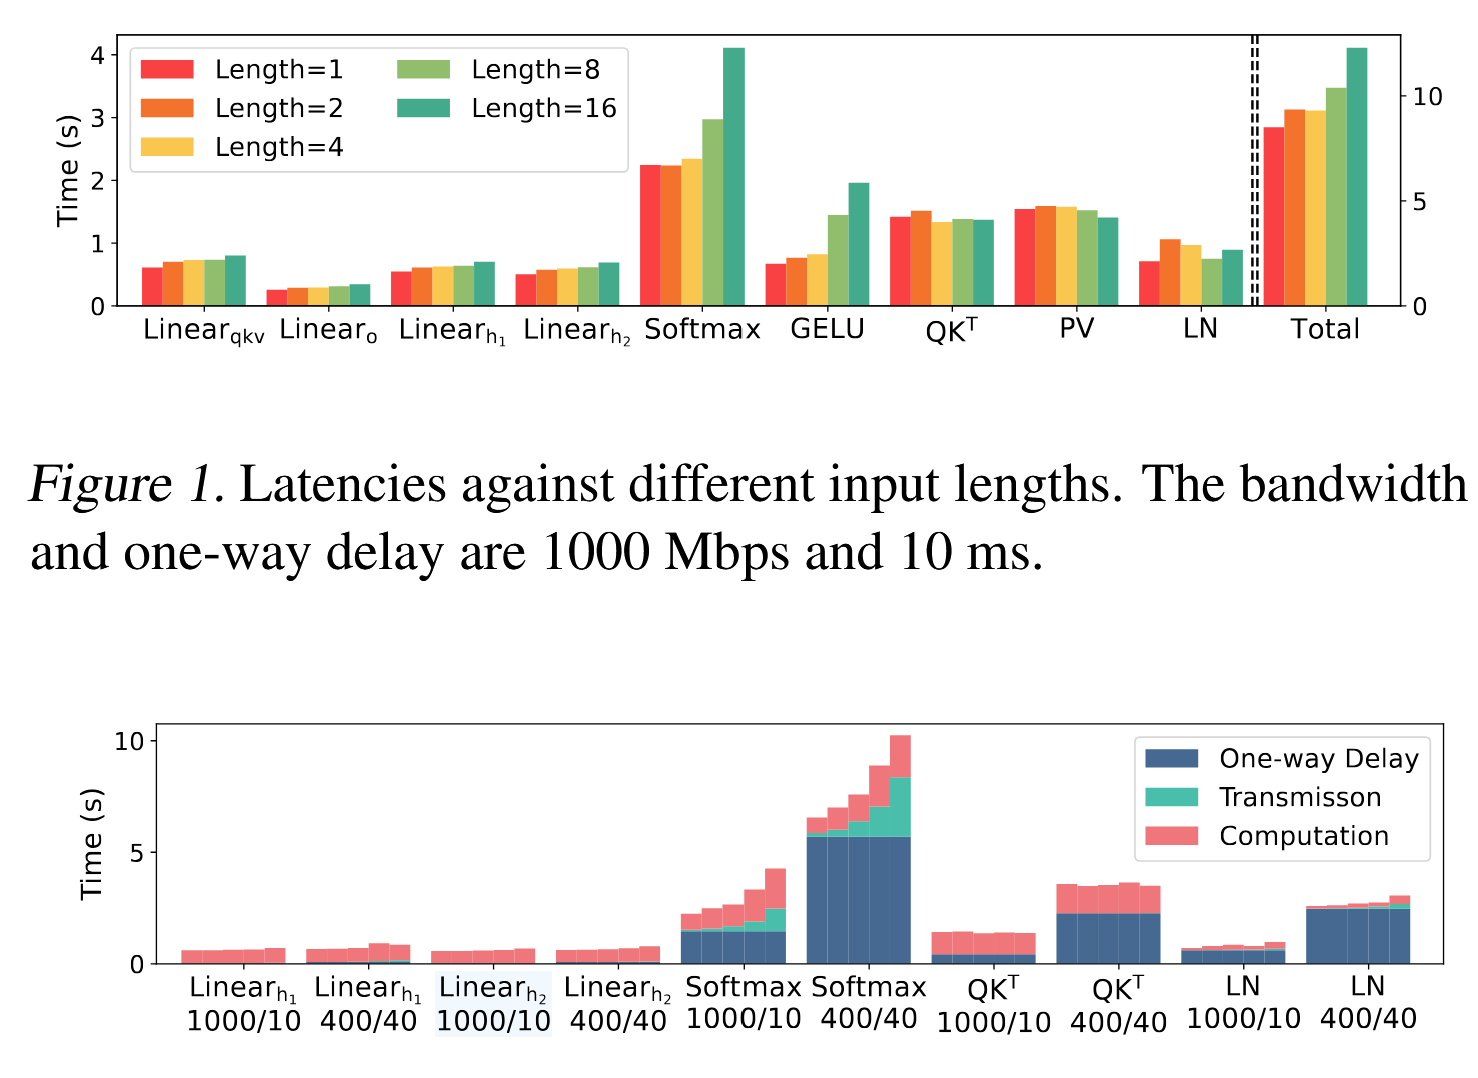
- (关键观察: 多验证几个 token 并没有贵很多) 在论文的 FLAN-T5-XL 分析中, 一次安全 decoder 计算从 1 个 token 增至 8 或 16 个 token, 延迟约变成原来的 $1.2\times$ 和 $1.5\times$. 原因有两点: 多个位置可以共享通信轮次, 摊薄网络往返等待; HE 的 SIMD 打包在单 token 时利用不足, 增加 token 有助于填满计算槽位. 这种现象发生在所测的小输入长度范围内, 不意味着任意长度都具有相同成本.
-
(POST: Public Decoding and Secure Verification) 每轮执行以下过程:
- 客户端根据当前前缀, 用公开模型自回归生成 $\gamma$ 个草稿 token.
- 双方通过安全推理并行计算这些候选位置及额外位置的目标分布, 分布暂时保持为秘密份额.
- 执行安全 speculative sampling, 保留首次拒绝前的连续草稿, 并生成一个修正 token; 若全部接受, 则从额外位置的目标分布生成 bonus token.
- 更新前缀, 开始下一轮.
标题强调的是私有模型不再逐 token 执行昂贵的安全解码. 客户端草稿仍然自回归生成, 最终输出也仍服从自回归条件分布.
-
(概率验证, 而非语义放宽) 对 $x_i\sim q_i$, 标准 speculative sampling 以如下概率接受:
$$ a_i = \min\left(1,\frac{p_i(x_i)}{q_i(x_i)}\right). $$首次拒绝时, 从归一化残差分布采样修正 token:
$$ p_i'(x) = \frac{[p_i(x)-q_i(x)]_+}{\sum_{v\in\mathcal{V}}[p_i(v)-q_i(v)]_+}. $$这比从目标分布独立采一个 token 后要求完全相同更容易接受草稿, 同时保持目标分布. 论文称其为 “soft matching”, 但它不依赖语义相似度阈值, 也没有放宽输出分布要求.
-
(优化一: 用乘法替代安全除法) 直接安全计算 $p_i(x_i)/q_i(x_i)$ 很昂贵. 令 $r_i\sim U(0,1)$, 等价地在以下条件下拒绝:
$$ r_iq_i(x_i)-p_i(x_i) > 0. $$$q_i$ 和随机数由客户端持有, 乘法可以本地完成, 然后与 $p_i$ 的秘密份额相减. 协议因此将核心判断转化为安全比较, 避免安全除法.
-
(优化二: 先选择, 后比较) 每个位置的分数向量有 $V$ 个元素, 但最终只需要草稿 token 对应的一个分数. 如果先为整个词表做安全比较, 大量计算都不会被使用. POST 通过不经意传输 (Oblivious Transfer, OT) 隐藏客户端选择的 token 索引, 先取得该元素的秘密份额, 再执行一次安全比较. 省下的是词表范围内的大量比较, 并非消除了与词表大小有关的通信. 服务端还会随机掩码其份额, 防止客户端直接读出目标概率.
-
(离线对齐: 提高草稿接受率) 客户端使用允许公开的语料向私有模型查询, 收集输出概率, 再通过交叉熵蒸馏公开模型. 若接口只提供 top-$K$ 概率, 则仅使用这些可获得的信息. 这一过程改善 $q$ 与 $p$ 的匹配, 不修改私有模型. 在线私密请求仍走安全协议; 离线明文查询的数据需要事先允许披露.
关键洞察
-
(安全保证的口径) 论文采用 semi-honest 威胁模型, 即双方遵循协议, 但可能尝试从观察到的信息推断额外内容. 协议会向客户端公开拒绝标志, 并通过 OT 取得首次拒绝位置或全部接受后的目标分布, 用于本地采样. 作者将这些输出与允许客户端获知输出分布的标准安全推理接口比较. 因此, 不能将其描述成只泄露最终文本, 或直接外推为对恶意参与方的安全保证.
-
(对齐确实改善接受率) Table 1 在草稿长度为 8 时给出了以下 Spider 结果. 同系列模型原本就较接近, 跨系列模型则有更大的对齐空间.
私有模型 公开模型 对齐前接受率 对齐后接受率 Vicuna-7B Llama-160M 0.302 0.592 FLAN-T5-XL T5-efficient-base 0.583 0.690 FLAN-T5-XL FLAN-T5-base 0.736 0.782 -
(端到端加速) 作者在 SecretFlow-SPU 上结合 Nimbus 的线性协议与 BumbleBee 的非线性协议, 测试三组模型搭配、四种任务. 两种模拟网络条件分别为 1 Gbps / 10 ms 单向延迟和 400 Mbps / 40 ms 单向延迟. 在 4、8、16 三种草稿长度中选择合适配置后, 相对标准安全解码报告 $2.1\times$-$6.0\times$ 加速. 基线是密码学保护下的推理, 不是普通 GPU 明文推理; 一次性的离线蒸馏也不是在线加速本身.
-
(采样协议不能照搬明文实现) Table 2 中, Vicuna-7B、草稿长度 8、1 Gbps / 10 ms 条件下, 朴素安全采样耗时 28.26 s, 优化后为 1.45 s. 同表单个 decoder 的安全计算耗时为 8.67 s. 这说明若不改写采样协议, 额外验证逻辑可能吞掉批量推理收益. 这里的单个 decoder 时间不能当成整个模型的端到端时间.
-
(更长的草稿并非总是更快) 首次拒绝之后的草稿都无法贡献输出. 即使公开模型在本地很便宜, 更长的安全 forward 与采样仍有成本. 在每步接受概率近似为常数 $\alpha$ 的简化条件下, 包含 bonus token 的每轮期望产出为
$$ \mathbb{E}[L] = 1+\alpha+\cdots+\alpha^\gamma =\frac{1-\alpha^{\gamma+1}}{1-\alpha}. $$因而论文使用的 $1/(1-\alpha)$ 应结合有限草稿长度理解, 不能直接当作任意 $\gamma$ 下的精确加速倍数. 全部草稿被拒绝时仍能产出一个 token, 但这本身不保证速度不会低于标准解码.
继往开来
-
POST 将投机解码的关注点从普通推理中的计算与显存带宽, 扩展到安全推理中的通信轮次、密文打包和安全比较. 它的核心价值在于联合安排推理流程与密码学协议: 用明文草稿减少昂贵的串行安全调用, 再让验证逻辑适合安全执行.
-
对后续系统的启发是, 草稿模型的大小与草稿长度应根据安全计算成本重新权衡. 当安全推理远比本地推理昂贵时, 更强的公开模型可能值得投入; 但实际收益仍取决于接受率、网络环境与客户端资源.