SpecInfer: Accelerating Large Language Model Serving with Tree-based Speculative Inference and Verification
Content
研究背景
-
(LLM 的推理瓶颈) 自回归 LLM 的瓶颈是逐 token decode: 每生成一个 token, 都要再次访问模型参数并依赖此前的 KV cache. 普通 speculative decoding 虽可让小模型预先猜一条序列, 但一旦其中一个 token 与 LLM 不一致, 后续整段猜测都失效. 单一路径的对齐概率会随长度快速下降.
-
(如何提高验证成功率?) SpecInfer 的转换很直接: 不要让小模型只给一条预测, 而是构造一棵 token tree, 将多条候选序列压缩在共享前缀下. LLM 不再充当 incremental decoder, 而是在一次 forward 中验证树上的所有节点. 目标是在不改变 greedy output 或 stochastic output distribution 的前提下, 用一次权重访问确认尽可能多的未来 token.
核心思想
- (算法)
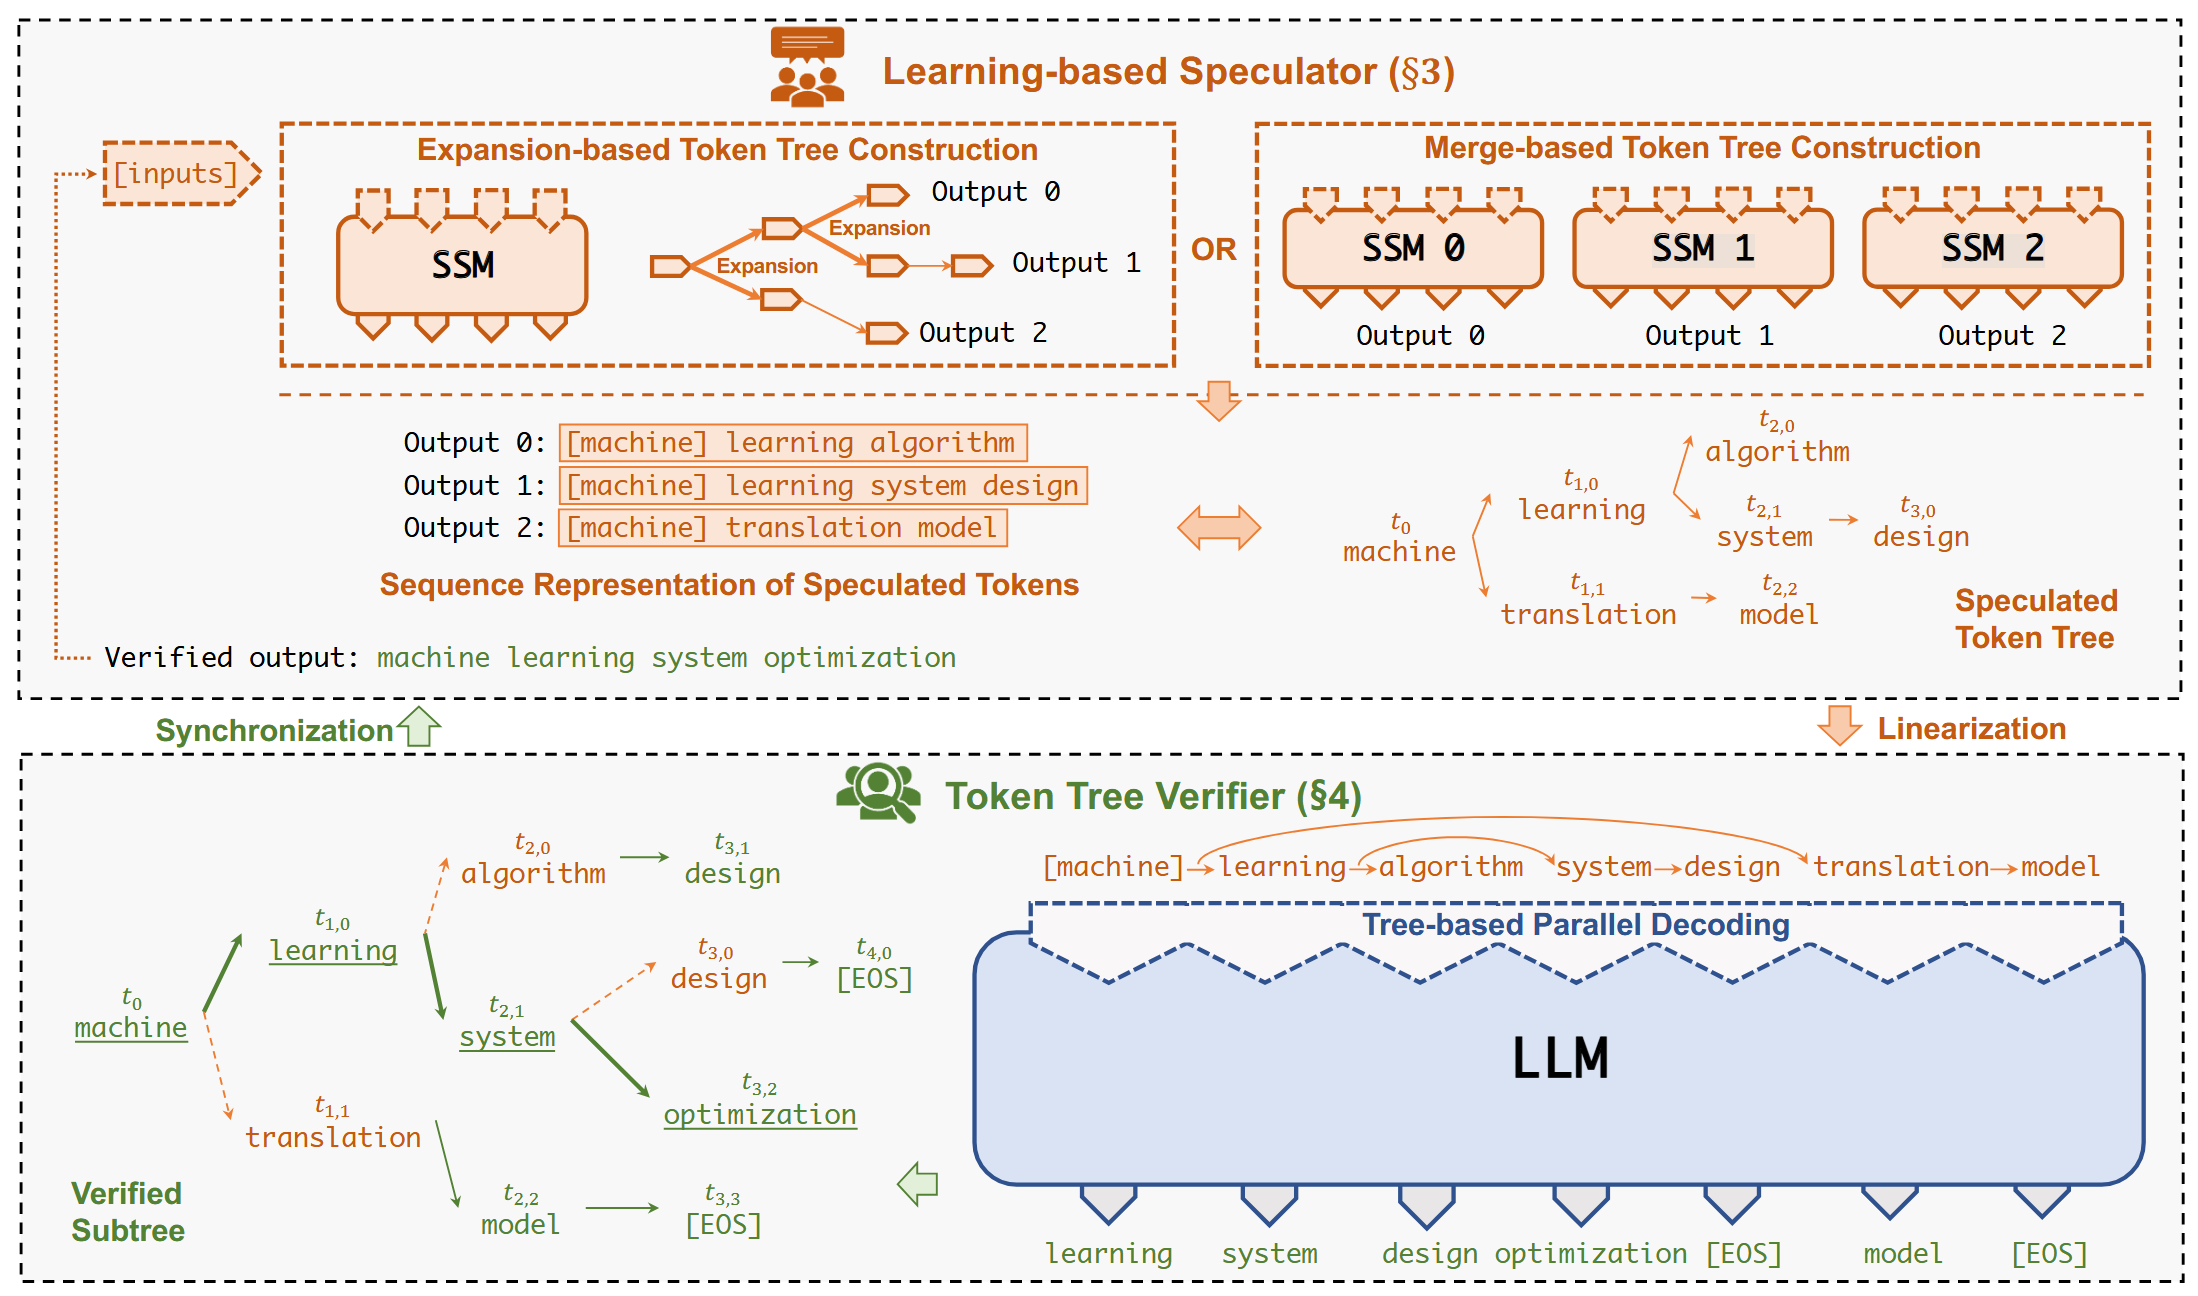
- 通过 Expansion/Merge 从单个或者多个小模型中采样构建 token tree;
- 利用 tree attention 快速计算每个 token 对应的概率 (目标 LLM);
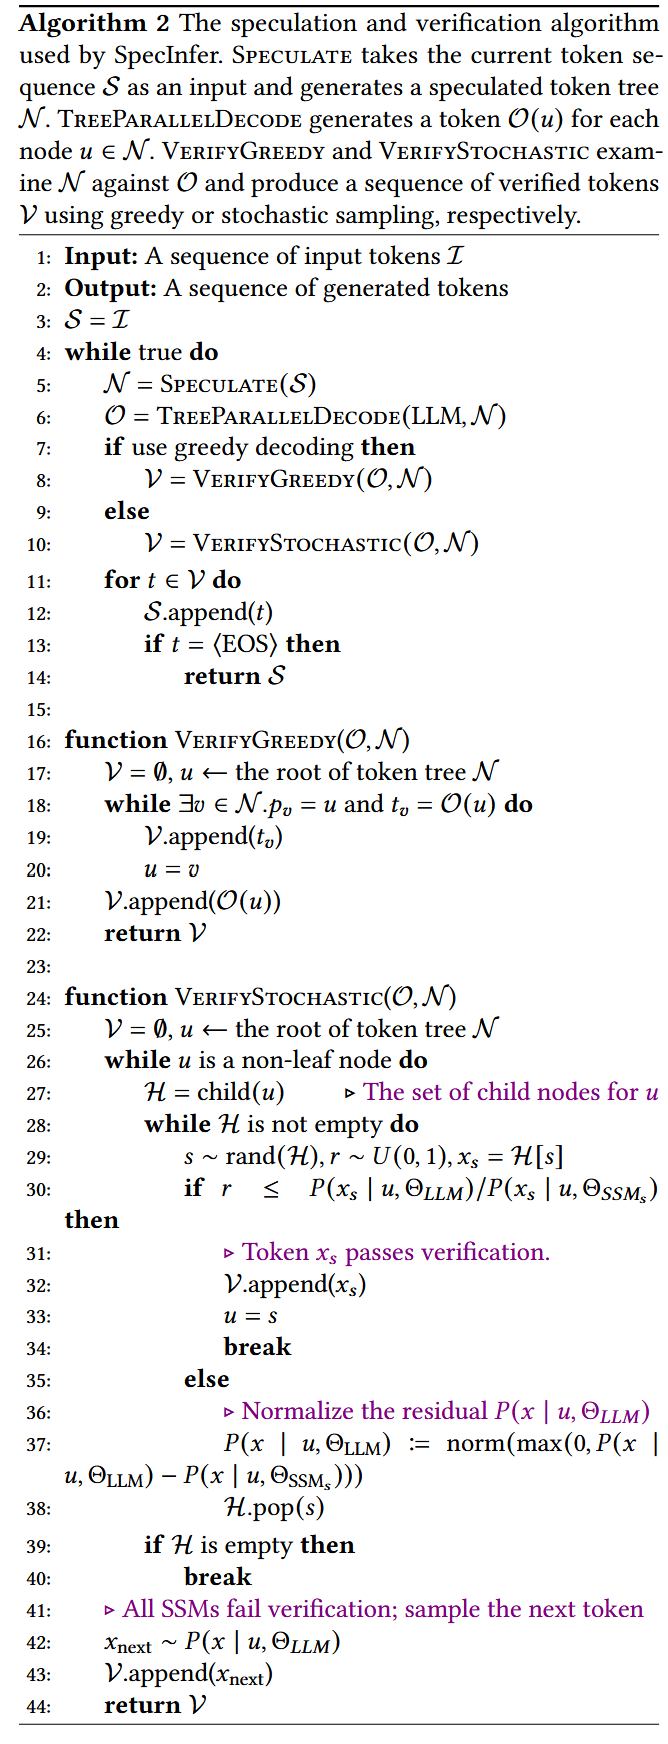
- (I) Greedy Decoding: 在每个节点判断子节点中是否存在目标 LLM 对应的最高概率的 token, 若存在则进入下一节点, 否则停止验证, 由目标 LLM 给出下一 token 并回到 Step 1; (II) Stochastic Decoding: 对子节点中的每一个节点按照传统 speculative sampling 的方式判断是否接受, 若某个子节点接受, 则继续验证, 否则从残差分布中采样并退出验证, 回到 Step 1.
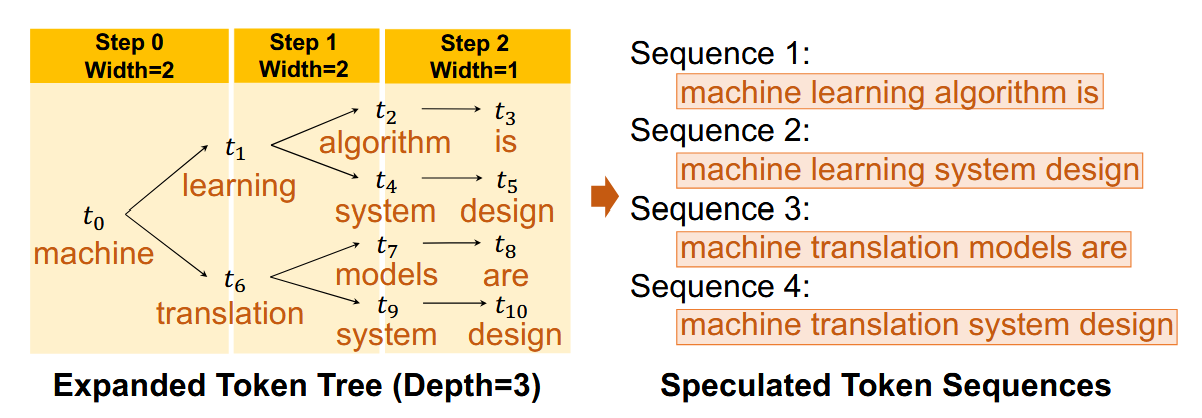
- (Token tree construction) SpecInfer 用小型 speculative models (SSMs) 产生候选, 再以两种方式形成树:
- Expansion: 通过单个SSM在生成序列的时候按照 $(k_1, k_2, \ldots, k_n)$ 的方式在第 $i$ 阶段采样 top-$k_i$ tokens. 如上图左所示, 按照宽度为 (2, 2, 1) 的方式采样, 最后总共形成 4 条序列.
- Merge: 希望通过结合多个SSMs来覆盖 LLM 的可能的输出, 各自采样序列后, 合并为一棵树, 这里的关键反而是如何微调 SSMs:
- 首先, 构造多个 prompts, 然后微调 SSM 要求其在 prompt 的输出上和目标 LLM 的输出保持一致;
- 经过微调后, 过滤掉那些已经能够输出一致的 prompt, 利用剩下的 prompts 继续微调其它 SSMs.
- 显然, 这种 boosting 的 SSMs 微调方式, 能够尽可能地保证 SSMs 在不同方面和目标 LLM 输出保持一致, 从而保证 “召回率”.
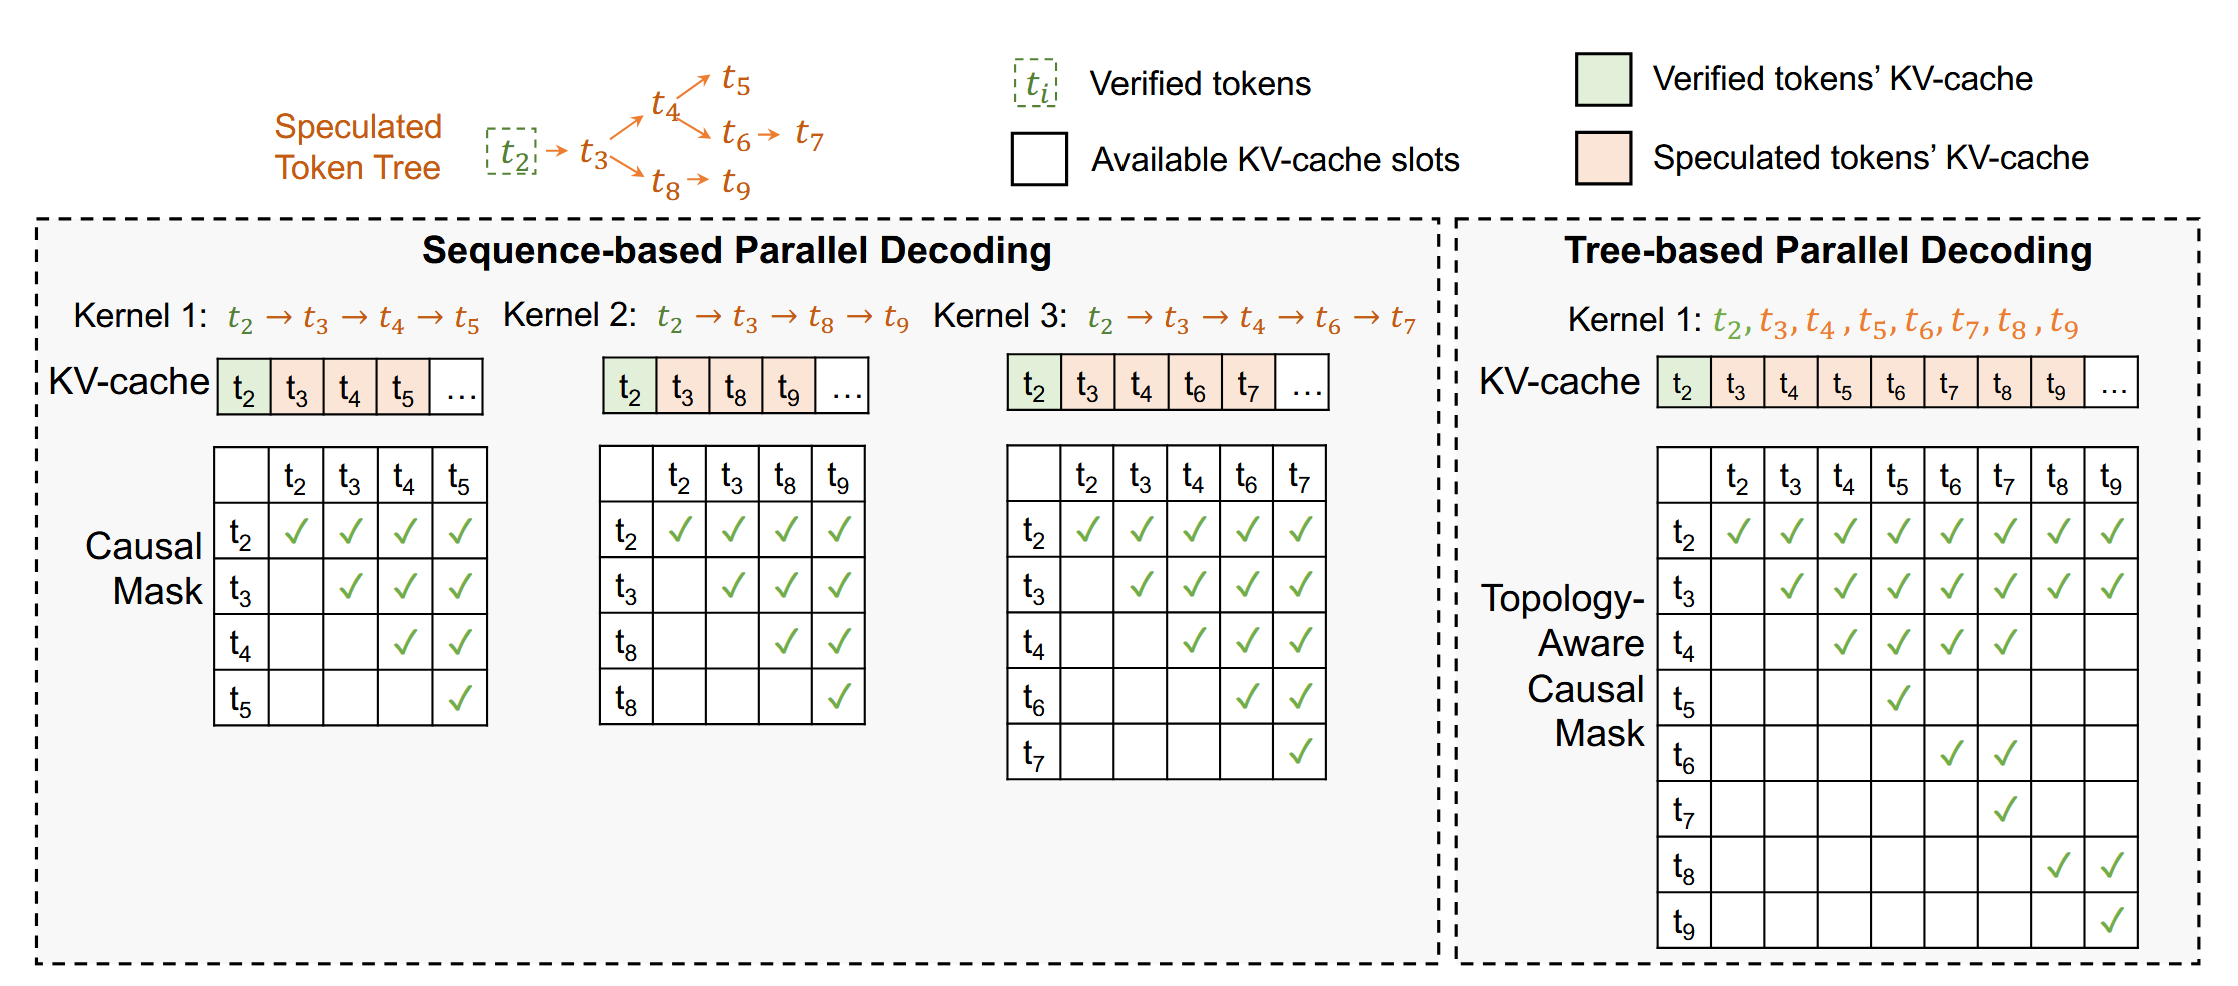
- (Tree attention and parallel decoding) 关键工程难点是: 树上的两个节点只应看见自己的祖先, 不能看见其他分支. 若把每条 root-to-leaf path 当独立 sequence 跑, 共享前缀会重复计算, 同时会复制 KV cache. SpecInfer 将树中的节点线性化放入同一 KV cache, 并把普通下三角 causal mask 改为 topology-aware mask: 节点只可 attend 到已验证 prefix 与自身祖先. 这样所有节点可在一个 kernel 中计算 attention, 但输出与逐条 sequence incremental decoding 完全相同. 实现上使用深度优先顺序维护共享 KV cache, 同时避免在分支之间复制已有前缀的 key/value.
注: 这里应该有一个 trade-off, 本质上 SpecInfer 的做法是把整棵树拉平为序列, 好处是能够避免一些重复的计算, 但坏处是序列变长后会导致 attention 的计算成本上升, 因此反而可能造成总体的成本增加.
-
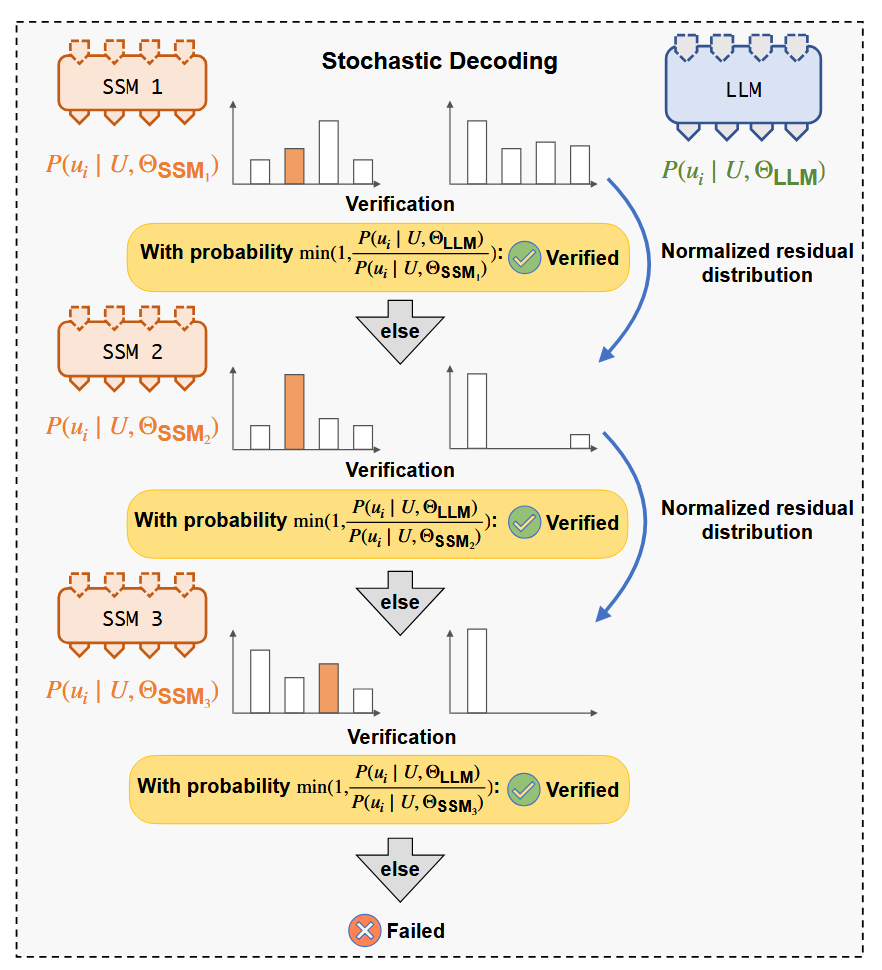
(Verification) 对 greedy decoding, verifier 从树根开始寻找 token 等于 LLM output 的 child, 找到则沿该 child 继续; 找不到时直接追加该位置的 LLM output. 因而它得到的序列与普通 greedy decoding 完全一致, 只是一次接受多个命中的 tree node. 对 stochastic decoding, 论文提出 multi-step speculative sampling (MSS). 它逐个尝试当前节点的 child, 以
$$ \min\left(1, \frac{P(x \mid u; \Theta_{\mathrm{LLM}})} {P(x \mid u; \Theta_{\mathrm{SSM}})} \right) $$的概率接受. 若某个 child 被拒绝, 就从 LLM 分布中扣除该 SSM 已提出的概率质量并归一化, 再考察下一 child; 所有 child 都失败时, 从剩余 LLM 分布采样. 这将单序列 speculative sampling 扩展到了多分支情形. 论文给出证明, MSS 的输出条件分布与原始 LLM stochastic decoding 一致, 且拒绝概率不高于“直接从 LLM 采一个 token, 再检查它是否属于 tree”的 naive sampling.
继往开来
- 作者将普通的单序列的 speculative decoding 扩展到了 tree, 使得在 SSMs 的选择和调度上有了更多扩展的机会.