SpecTr: Fast Speculative Decoding via Optimal Transport
Content
研究背景
-
(单序列投机解码) 自回归 LLM 每生成一个 token 都依赖此前的输出, 大模型的串行调用构成了生成延迟的重要来源. Speculative Decoding 利用小模型提前猜测, 再让大模型并行验证这些猜测, 从而减少串行调用次数.
-
(多序列投机解码) SpecTr 希望进一步利用 batch 维度, 同时验证多条 draft sequences. 多一些候选通常更容易覆盖 target model 的可能输出, 但选择规则必须精确控制概率: 最终输出的分布仍然要与 target model 一致.
-
(符号说明)
- $p$: draft distribution;
- $q$: target distribution;
- $\Omega$: 样本空间, 在 LLM 中对应词表;
- $\mathcal{M}_d(\cdot|x^t)$: draft model with context $x^t$;
- $\mathcal{M}_t(\cdot|x^t)$: target model with context $x^t$;
- $E$: 直接接受候选的事件, $E^c$ 表示所有候选均被拒绝, 转入残差采样;
- $\mathcal{S}(X_{1:k})$: 候选中出现过的 token 的集合, 仅用于判断输出是否命中候选.
核心思想
投机解码先由较小的模型 $\mathcal{M}_d(\cdot|x^t)$ 生成候选, 再由目标模型 $\mathcal{M}_t(\cdot|x^t)$ 验证, 通过接受与残差采样保证最终输出分布不变. 下面先回顾如何利用来自 $p$ 的候选生成服从 $q$ 的输出, 再从最优传输的角度解释这一设计及其多候选扩展. 核心是概率质量 (probability mass) 的分配: 尽可能保留候选对应的 mass, 再补齐目标分布的缺额.
传统投机解码回顾
- 采样 $X \sim p(x)$;
- 若 $p(X) \le q(X)$, 则接受 $Y = X$;
- 若 $p(X) > q(X)$, 则以 $q(X) / p(X)$ 的概率接受 $Y = X$, 否则, $Y$ 从如下残差分布中采样:
-
(推导) 上述过程保持目标分布不变, 可以直接通过 mass 分解证明:
-
定义
$$ a(x) = \min(1, \frac{q(x)}{p(x)}), \quad m(x) = a(x) p(x) = \min(p(x), q(x)). $$ -
接受率 ($P_A$) 与拒绝率 ($P_R$):
$$ \begin{aligned} P_A &:= \mathbb{P}(E) = \sum_{x \in \Omega} p(x) a(x) = \sum_{x \in \Omega} \min(p(x), q(x)), \\ P_R &:= \mathbb{P}(E^c) = 1 - P_A = 1 - \sum_{x \in \Omega} m(x). \end{aligned} $$ -
采样概率:
$$ \begin{align*} \mathbb{P}(Y = y) &= \mathbb{P}(Y = y, E) + \mathbb{P}(Y = y, E^c) \\ &= m(y) + \frac{q(y) - m(y)}{1 - \sum_{x} m(x)} (1 - \sum_{x \in \Omega} m(x)) \\ &= m(y) + q(y) - m(y) = q(y). \end{align*} $$
接受概率中的比值只需在 $p(x) > 0$ 时计算, 因为候选不会落在 $p(x)=0$ 的位置. 若 $P_A=1$, 则无需定义或采样残差分布.
-
单候选的 coupling: 对角线优先, 残差补齐
从 coupling 可以更好地理解传统的投机解码为何如此设计.
-
(Coupling) Coupling 是具有给定边际分布 $p(x),q(y)$ 的联合分布 $\pi(x,y)$, 满足:
$$ \tag{2} \pi(x, y) \ge 0, \quad \sum_{y} \pi(x, y) = p(x), \quad \sum_{x} \pi(x, y) = q(y). $$ -
(通过 coupling 采样) 先采样 $X\sim p$, 再根据联合分布给出的条件概率采样 $Y$, 即可得到目标边际分布 $q$:
$$ Y \sim \pi(X, y) / p(X), \quad X \sim p(x). $$ -
(最优 coupling) 满足条件 (2) 的 coupling 通常不唯一. 对单候选投机解码而言, 目标是在保持边际分布不变的前提下, 尽可能复用小模型生成的 token, 即最大化 $Y=X$ 的概率. 记所有合法 coupling 的集合为 $\Pi(p,q)$, 则
$$ \tag{3} \max_{\pi\in\Pi(p,q)} \mathbb{P}_{\pi}(Y = X) = 1 - \min_{\pi\in\Pi(p,q)} \mathbb{E}_{\pi}\left[ \mathbb{I}(Y \ne X) \right]. $$右侧的最小化项就是代价函数为 $\mathbb{I}(Y\ne X)$ 的最优传输问题.
-
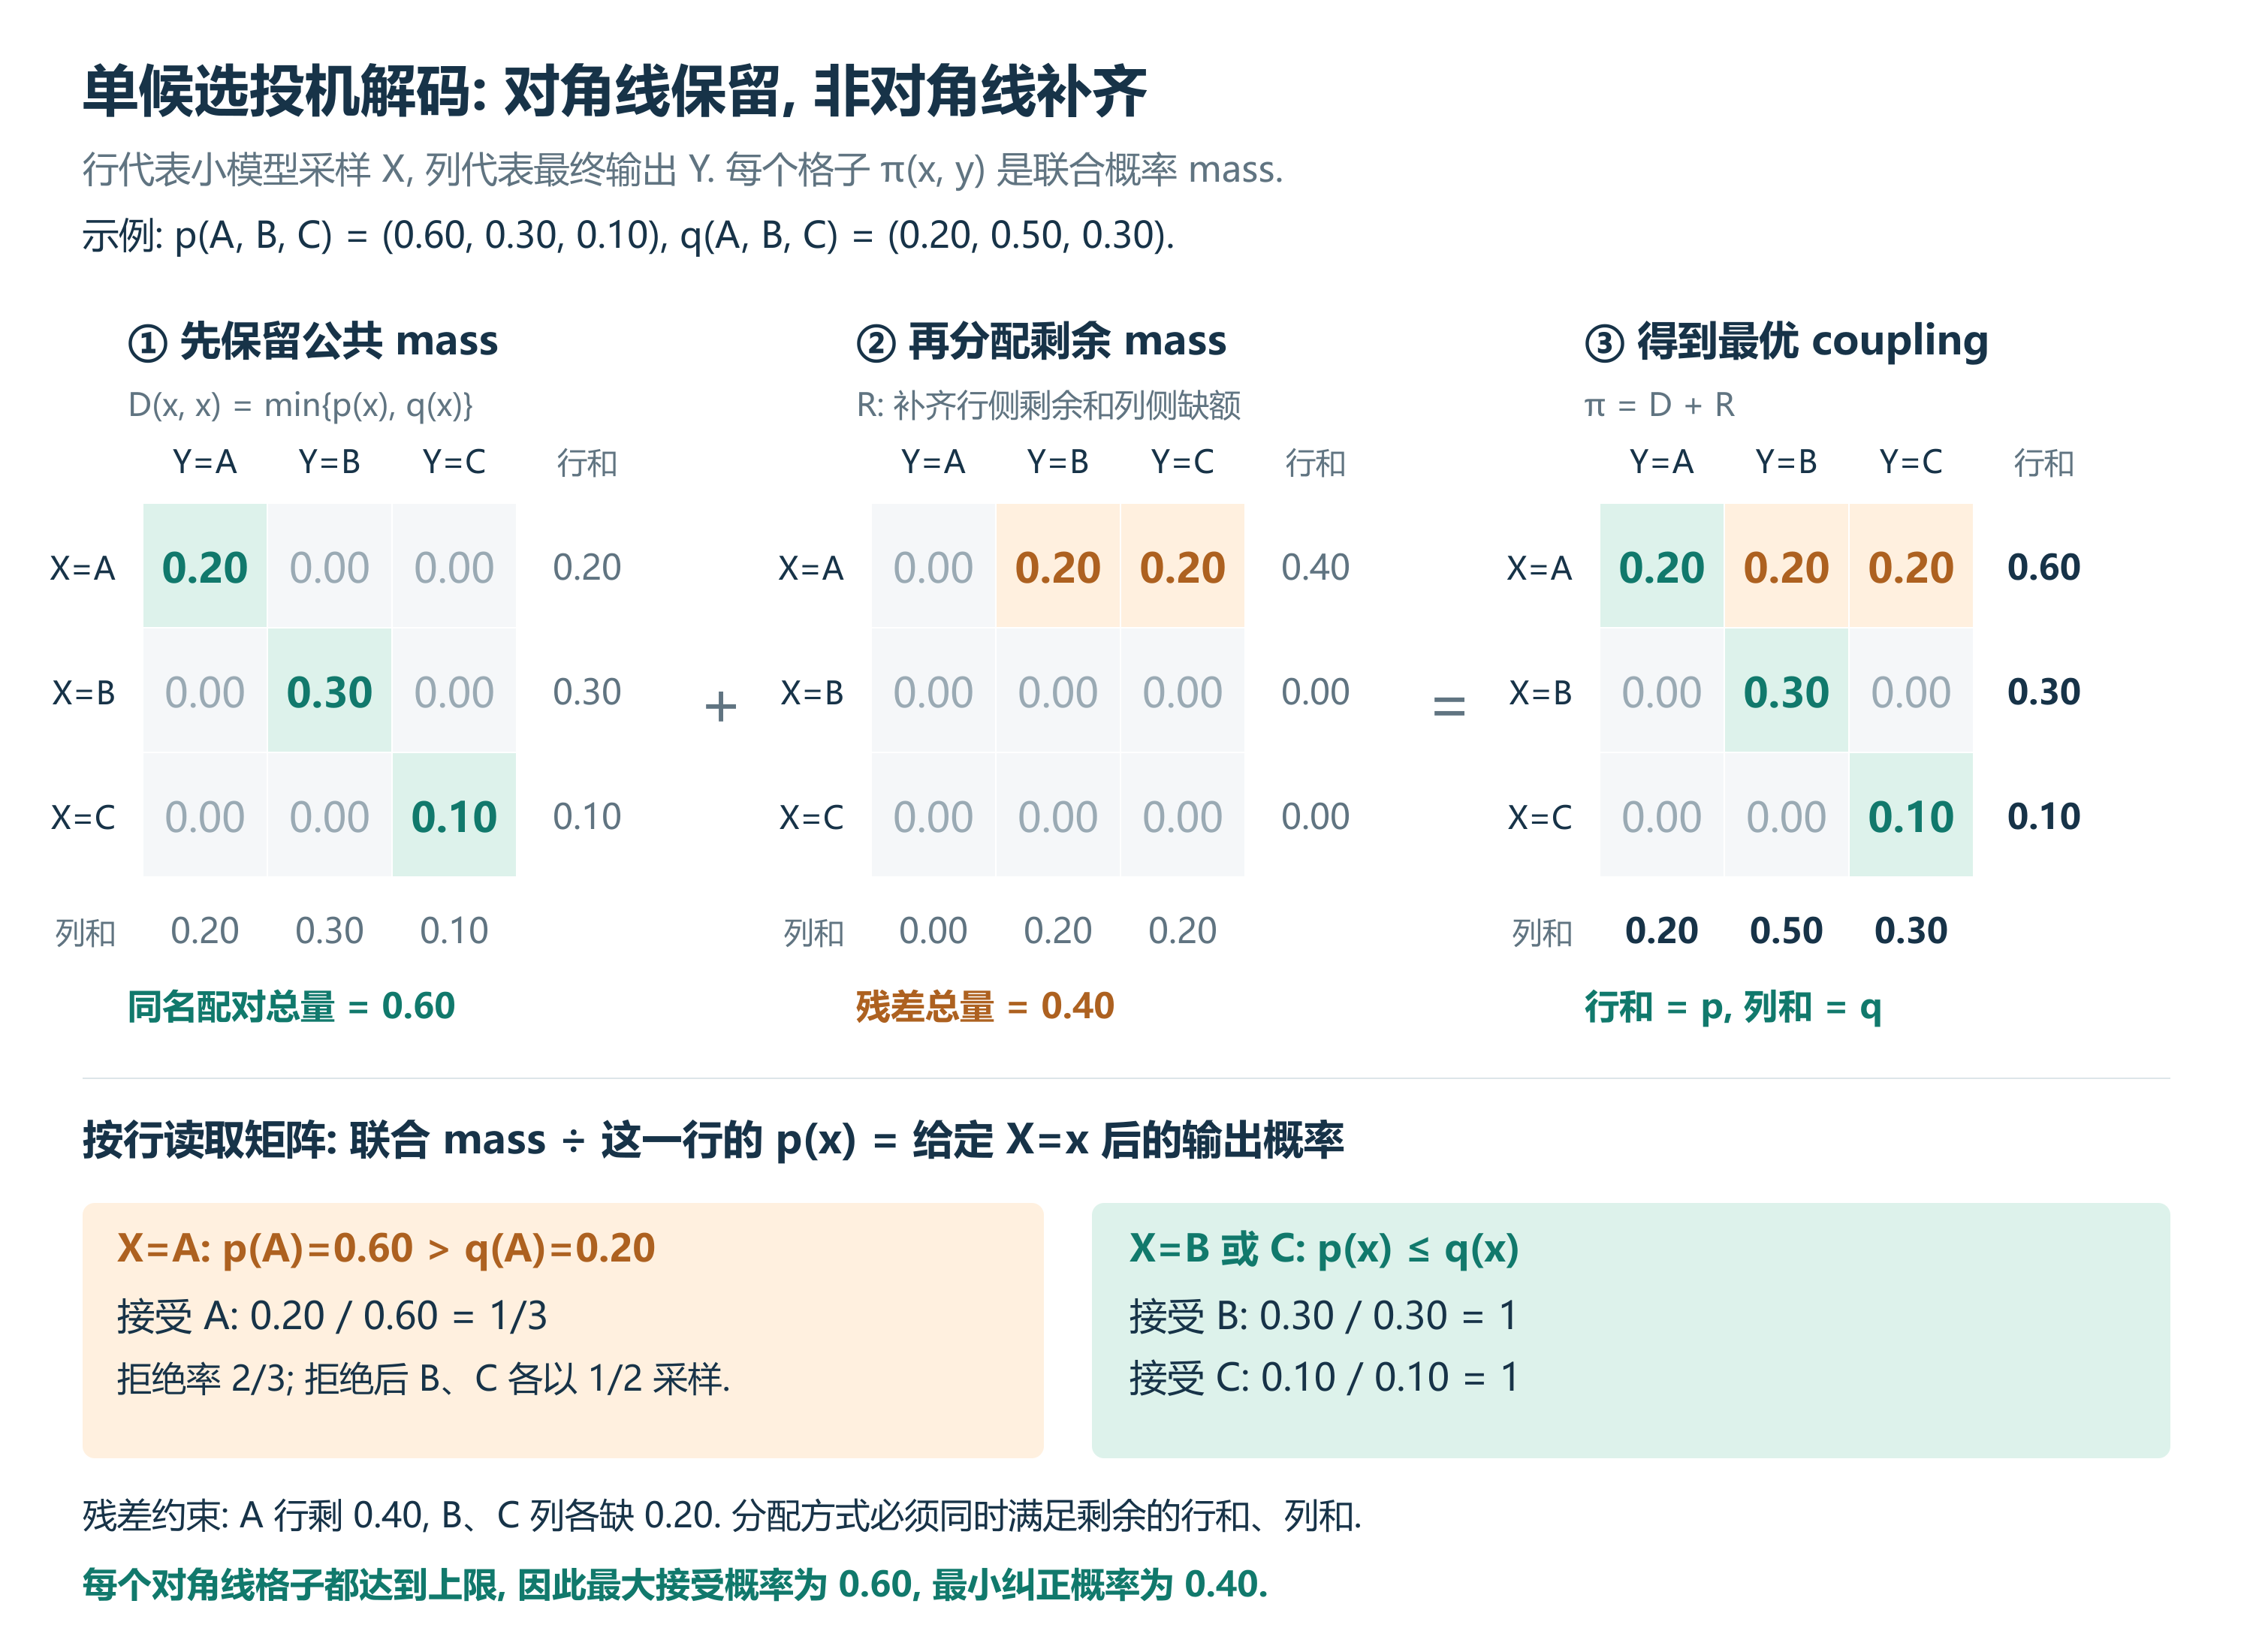
(求解思路) 将 $\pi$ 看作 mass 分配矩阵: 行预算为 $p(x)$, 列预算为 $q(y)$. 对角线 $\pi(x,x)$ 表示保留候选 $x$ 的 mass, 最多为 $\min(p(x),q(x))$. 因此, 应先尽可能填满对角线:
- 若 $p(x)\le q(x)$, 则该行的 mass 可以全部保留, 接受概率为 $1$;
- 若 $p(x) > q(x)$, 则保留 $q(x)$ 的 mass, 对应接受概率 $q(x)/p(x)$. 剩余 mass 分配到尚有缺额的列.
令 $m(x)=\min(p(x),q(x))$. 剩余矩阵 $R$ 必须非负, 且行和为 $p(x)-m(x)$, 列和为 $q(y)-m(y)$. 剩余供给与目标缺额的支撑不重叠, 因此这些 mass 都位于非对角线. 在满足剩余行和与列和的前提下, 可以任意分配, 不影响对角线总量.
-
(一一对应) 传统投机解码正好实现了上述分配, 因而在单候选、单 token 情形下达到最优接受率:
| 条件 | mass 分配 | 采样规则 |
|---|---|---|
| $p(x)\le q(x)$ | 保留该行全部 mass $p(x)$ | 接受 $Y=X$ |
| $p(x) > q(x)$ | 保留 mass $q(x)$ | 以 $q(X)/p(X)$ 的概率接受 $Y=X$ |
| 候选被拒绝 | 将剩余 mass 分配到有缺额的列 | 从残差分布中采样 |
-
例如, 对 tokens A, B, C, 取
$$ p=(0.6,0.3,0.1),\qquad q=(0.2,0.5,0.3). $$对角线最多分别分配 $0.2,0.3,0.1$, 合计 $0.6$. 此后, 行侧只有 A 剩余 $0.4$, 列侧只有 B 和 C 各缺 $0.2$. 将剩余质量分配到 $(A,B)$ 和 $(A,C)$ 即可:
$$ \pi^*= \begin{pmatrix} 0.2&0.2&0.2\\ 0&0.3&0\\ 0&0&0.1 \end{pmatrix}. $$行和为 $p$, 列和为 $q$, 对角线总量恰好达到上界 $0.6$. 因而这个 coupling 最优.
多候选拓展
-
(多个候选) 利用设备的并行推理能力, 可以同时验证多个候选 token. 此时, 目标从 $Y=X$ 扩展为 $Y$ 命中任意候选:
- 从 $p$ 中独立采样 $k$ 个 tokens $X_{1:k}$;
- 在保持 $Y\sim q$ 的前提下, 最大化候选命中概率:
集合 $\mathcal{S}$ 只用于判断命中与否. 采样对象仍然是包含重复项的候选元组 $X_{1:k}$, 其联合分布为 $p^{\otimes k}$.
-
(例子) 取 $p=(0.6,0.4)$, $q=(0.3,0.7)$, $k=2$. 候选元组 AA, AB, BA, BB 的行预算分别是 $0.36,0.24,0.24,0.16$. 可以构造
$$ \begin{array}{c|cc|c} &Y=A&Y=B&\text{row sum}\\ \hline AA&0.30&0.06&0.36\\ AB&0&0.24&0.24\\ BA&0&0.24&0.24\\ BB&0&0.16&0.16\\ \hline \text{column sum}&0.30&0.70&1 \end{array}. $$矩阵中只有 $AA\rightarrow B$ 和 $BB\rightarrow A$ 不命中候选. 这些位置的 mass 仍是合法分配, 但不计入候选命中率. 因此, 该分配的命中率为:
$$ \mathbb{P}(Y \in \mathcal{S}(X_{1:k})) = 0.30 + 0.24 + 0.24 + 0.16 = 0.94. $$这高于单候选的最优接受率 $\min(0.6,0.3)+\min(0.4,0.7)=0.7$.
-
(挑战) 多候选 coupling 可以通过线性规划求解, 但矩阵包含 $|\Omega|^k$ 行和 $|\Omega|$ 列. 当词表或候选数较大时, 精确求解的计算代价很高.
K-SEQ 的出发点: 多次尝试不能超出 q 的预算
-
(朴素想法) 能否对每个独立候选都使用原来的 $\min\{1,q(X_i)/p(X_i)\}$ 接受概率, 直到成功? 假设 $p(A)=1$, $q(A)=q(B)=1/2$, 两个候选必然都是 A. 每次以 $1/2$ 接受, 则候选分支已经向 A 分配
$$ \frac12+\frac12\cdot\frac12=\frac34 $$的 mass, 超过了 $q(A)=1/2$. 后续无法通过 residual 补救, 因为那将需要给 A 分配负概率.
-
(控制配额) K-SEQ 引入分割系数 $\rho\in[1,k]$, 降低单次接受概率, 将每个 token 的单次接受 mass 限制在 $q(x)/\rho$ 以内:
$$ \tag{4} a_\rho(x)=\min\left\{1,\frac{q(x)}{\rho p(x)}\right\}, \qquad m_\rho(x)=p(x)a_\rho(x) =\min\left\{p(x),\frac{q(x)}{\rho}\right\}. $$$m_\rho(x)$ 是一次尝试中"采到 $x$ 并接受它"的 mass. 它既不能超过候选来源 $p(x)$, 又受 $q(x)/\rho$ 的上限约束, 为重复尝试预留预算.
-
($\rho=k$) 当 $\rho=k$ 时, 相当于将每个 token 的目标预算 $q(x)$ 平均分成 $k$ 份. 每次尝试向 $x$ 分配的 mass 至多为 $q(x)/k$, 累计至多为 $q(x)$, 因而残差不会为负. 但后续尝试只有在此前全部拒绝时才会发生, 实际占用可能远低于这份预留预算. 因此, 这一选择通常较为保守.
-
(接受率) 对一般的 $\rho$, 令 $I$ 表示首个被接受的候选下标, 全部拒绝时令 $I=\infty$. 第 $i$ 次尝试首次成功并输出 $x$ 的概率为:
$$ \tag{5} \mathbb{P}(I=i,Y=x) = \underbrace{(1 - \beta(\rho))^{i-1}}_{\text{前 }i-1\text{ 次拒绝}} \underbrace{a_{\rho}(x)}_{\text{第 }i\text{ 次接受}} p(x), \quad \beta(\rho) := \sum_x m_{\rho}(x). $$因此拒绝率和接受率分别为:
$$ P_R = \mathbb{P}(E^c) = (1 - \beta)^k, \quad P_A = \mathbb{P}(E) = 1 - (1 - \beta)^k. $$将各次尝试的贡献相加, 得到直接接受分支分配给每个 token $x$ 的 mass:
$$ \begin{align*} A_\rho(x) := \mathbb{P}(E,Y=x) &= \sum_{i=1}^k (1 - \beta)^{i-1} a_{\rho}(x) p(x) \\ &= \frac{1 - (1 - \beta)^k}{\beta} a_{\rho}(x) p(x) \\ &= \frac{1 - (1 - \beta)^k}{\beta} m_{\rho}(x) \\ &= \frac{P_A}{\beta} m_{\rho}(x). \end{align*} $$这里 $P_A$ 仅表示直接接受候选的概率, 不等同于 $\mathbb{P}(Y\in\mathcal{S}(X_{1:k}))$: 残差采样也可能命中候选. 以下涉及 $P_A/\beta$ 的推导先假设 $\beta > 0$.
-
(合法的 $\rho$) 为使残差非负, 直接接受分支在每个 token 上分配的 mass 都不能超过目标预算:
$$ \tag{6} \frac{P_A}{\beta} m_{\rho}(x) \le q(x), \quad \forall x. $$由于 $m_\rho(x)\le q(x)/\rho$, 以下不等式是满足 (6) 的一个充分条件:
$$ \tag{7} 1 - (1 - \beta)^k \le \rho \beta. $$ -
(为何不低于单候选?) 选择满足 $1-(1-\beta(\rho^*))^k=\rho^*\beta(\rho^*)$ 的 $\rho^*\in[1,k]$. 论文证明, $\rho\ge\rho^*$ 时构造合法. 由于 $\beta(\rho)$ 和 $P_A$ 均随 $\rho$ 不增, $\rho^*$ 在这一范围内最大化直接接受概率. 此时 $P_A=\rho^*\beta(\rho^*)$, 因而
$$ \begin{aligned} A_{\rho^*}(x) &= \frac{P_A}{\beta(\rho^*)}m_{\rho^*}(x) = \rho^*m_{\rho^*}(x) \\ &= \min(\rho^*p(x),q(x)) \ge \min(p(x),q(x)). \end{aligned} $$因此, 直接接受的总 mass 不低于单候选. 当 $p(x)\ge q(x)$ 时, 该 token 的预算仍恰好填满; 当 $p(x) < q(x)$ 时, 多次尝试可将接受 mass 从 $p(x)$ 提高到 $\min(\rho^*p(x),q(x))$, 且不会超额. 这里保证的是"不低于", 而非总是严格提高; 例如 $p=q$ 时单候选已达到接受率 $1$. 此外, K-SEQ 是多候选最优传输的近似解, 不能据此声称其 coupling 全局最优.
-
(直观理解) 一个特例可以说明额外的接受 mass 来自哪里. 假设存在一个固定的有限 $\rho\ge1$, 使得 $q(x)/\rho\le p(x)$ 对所有 $x$ 成立. 对任意 $k\ge\rho$, 有
$$ \beta(\rho) = \sum_{x} m_{\rho}(x) = \sum_x \min(p(x), q(x) / \rho) = \sum_x q(x) / \rho = 1 / \rho. $$$$ A_\rho(x) = \frac{P_A}{\beta}m_\rho(x) = \left[1-\left(1-\frac1\rho\right)^k\right]q(x) \xrightarrow[k\to\infty]{} q(x). $$在这个特例中, 每次尝试的接受 mass 都按 $q$ 的比例分配. 固定 $\rho$ 并增加 $k$, 就能逐步填补各 token 的缺额, 同时始终不超过 $q(x)$. 因此, 直接接受分支逐渐承担全部目标 mass, 需要残差补齐的部分趋于零. 这里的固定 $\rho$ 不必等于前一段随 $k$ 变化的 $\rho^*$.
残差分布
-
一旦候选分支的 mass $A_\rho(x)$ 合法, residual 就可以按缺额构造:
$$ q_{\mathrm{res}}(x) =\frac{q(x)-A_\rho(x)}{1-P_{A}}. $$分子是每个 token 尚未被分配的 mass, 分母是总缺额, 也正是进入 residual 分支的概率. 因此
$$ \Pr(Y=x) =A_\rho(x) +(1-P_{A})q_{\mathrm{res}}(x) =q(x). $$若 $\beta=0$, 候选与目标分布没有重叠, 直接令 $A_\rho(x)=0$ 并从 $q$ 采样. 若 $P_A=1$, 则无需进入残差分支. 这两种情形均不应直接计算上述含零分母的表达式.
SpecTr
-
(生成 $K$ 条序列) 给定当前 prefix $h$, 从小模型独立采样 $K$ 条长度为 $L$ 的 draft sequences, 并保存各位置的 draft distributions. 候选允许重复, 相同前缀下的多个独立样本不能随意去重.
-
(大模型并行计算) 将所有 draft prefixes 交给 target model, 沿 time 和 batch 两个维度并行计算条件分布. 这一步预先计算后续可能用到的 $q$, 包括完整 draft 后的额外 next-token distribution. 并行 batch 的实际延迟受硬件和实现影响.
-
(在当前位置分配 mass) 收集当前候选序列的第一个 token, 得到一个保留重复项的候选列表. 将其对应的 $p,q,k$ 输入 K-SEQ, 得到服从 $q$ 的输出 $Y$. 重复值在这里仍表示不同的采样机会; membership 判断时只需检查 token 是否出现过.
-
(按输出 prefix 筛选候选) 输出 $Y$, 保留所有首 token 等于 $Y$ 的候选, 并去掉它们的首 token. 若仍有候选, 则将 prefix 更新为 $(h,Y)$, 在下一位置重新计算相应的 $\rho$ 并执行 K-SEQ. 候选数从 $K$ 变成剩下的 $k$, 通常逐渐减少.
-
(判断何时结束) 若 $Y$ 不在当前位置的候选集合中, 后续 prefix 对应的大模型分布没有预先计算, 因此结束本轮. 即使 $Y$ 来自 residual 分支, 只要它仍命中候选, 就可以继续. 若已经走完长度 $L$ 且最后一步命中, 则从缓存的大模型分布再采样一个 token, 再结束本轮.
关键洞察
-
(多候选并非独立拒绝采样) 多候选的关键在于联合选择, 而不仅是增加采样次数. 如果直接重复使用单候选的接受概率 $\min(1,q(X_i)/p(X_i))$, 累计接受 mass 可能超过某些 token 的目标预算, 无法再通过残差保证最终边际分布为 $q$. 最优传输统一描述了候选覆盖率与输出分布约束.
-
(理论 block efficiency 不等于实际加速) 在 LM1B 的 1000 个 prompts, 3 个 random seeds 上, PaLM-2 Gecko/Bison 组合使用 $K=8,L=8$ 时, block efficiency 从 baseline 的 1.0 提升至 4.0, 但实际 wall-clock speedup 为 $2.13\times$. 这高于同样取 $L=8$ 的单候选 speculative decoding 的 $1.56\times$, 相对进一步加速约 $1.37\times$. 表中单候选在 $L=4$ 时为 $1.67\times$, 若比较各自表内最佳配置, 比值约为 $2.13/1.67=1.28\times$.
继往开来
- 最优传输为投机解码提供了统一的 mass 分配视角: 单候选尽可能填满对角线, 多候选则尽可能将 mass 分配给候选集合内的输出, 剩余部分在满足目标边际的前提下补齐.
参考文献
- Sun Z., Suresh A. T., Ro J. H., Beirami A., Jain H. and Yu F. SpecTr: Fast Speculative Decoding via Optimal Transport. Advances in Neural Information Processing Systems, 2023. [PDF]