Universal Item Tokenization for Transferable Generative Recommendation
Content
研究背景
-
(可迁移生成式推荐) TIGER 使用预先提取的内容向量训练 RQ-VAE, 将 item 映射为 Semantic ID, 再训练生成模型预测目标 ID. 当内容向量、tokenizer 和推荐模型主要来自单个域时, 迁移到新域容易遇到语义覆盖不足与编码关系改变的问题.
-
(UTGRec) 本文将多模态内容编码与量化联合训练, 在多个域上学习通用 tokenizer, 并以统一编码空间预训练生成式推荐模型. 迁移阶段再分别适配 tokenizer 与推荐模型.
-
(符号说明)
- $i$: item; $T_i,V_i$: 对应文本与图像; $i^+$: 用户序列中与 $i$ 相邻的正样本 item.
- $L$: item 编码长度, 默认取 $3$.
- $\mathbf{H}=[\bm{h}_1,\ldots,\bm{h}_L]$: 多模态模型输出的 $L$ 个内容表示.
- $\bm{h}'_l$: 第 $l$ 个内容表示经 MLP 投影后的向量; $d_c$: 码本维度.
- $\widetilde{\bm{h}}_l$: 量化前的基本表示或增量表示; $\widehat{\bm{h}}_l$: 从码向量恢复的离散内容表示.
- $\mathbf{C}_r=\mathbf{E}_r\mathbf{W}_r$: 根码本; $\mathbf{C}_f=\mathbf{E}_f\mathbf{W}_f$: 叶码本.
- $\mathbf{E}_r,\mathbf{E}_f$: 码本参数矩阵; $\mathbf{W}_r,\mathbf{W}_f \in \mathbb{R}^{d_c \times d_c}$: 共享于相应码本各行的投影矩阵.
- $c_l$: 第 $l$ 个离散索引; $(c_1,\ldots,c_L)$ 构成 item ID.
- $X,Y$: 用户历史对应的编码序列与目标 item 的编码序列.
核心思想
-
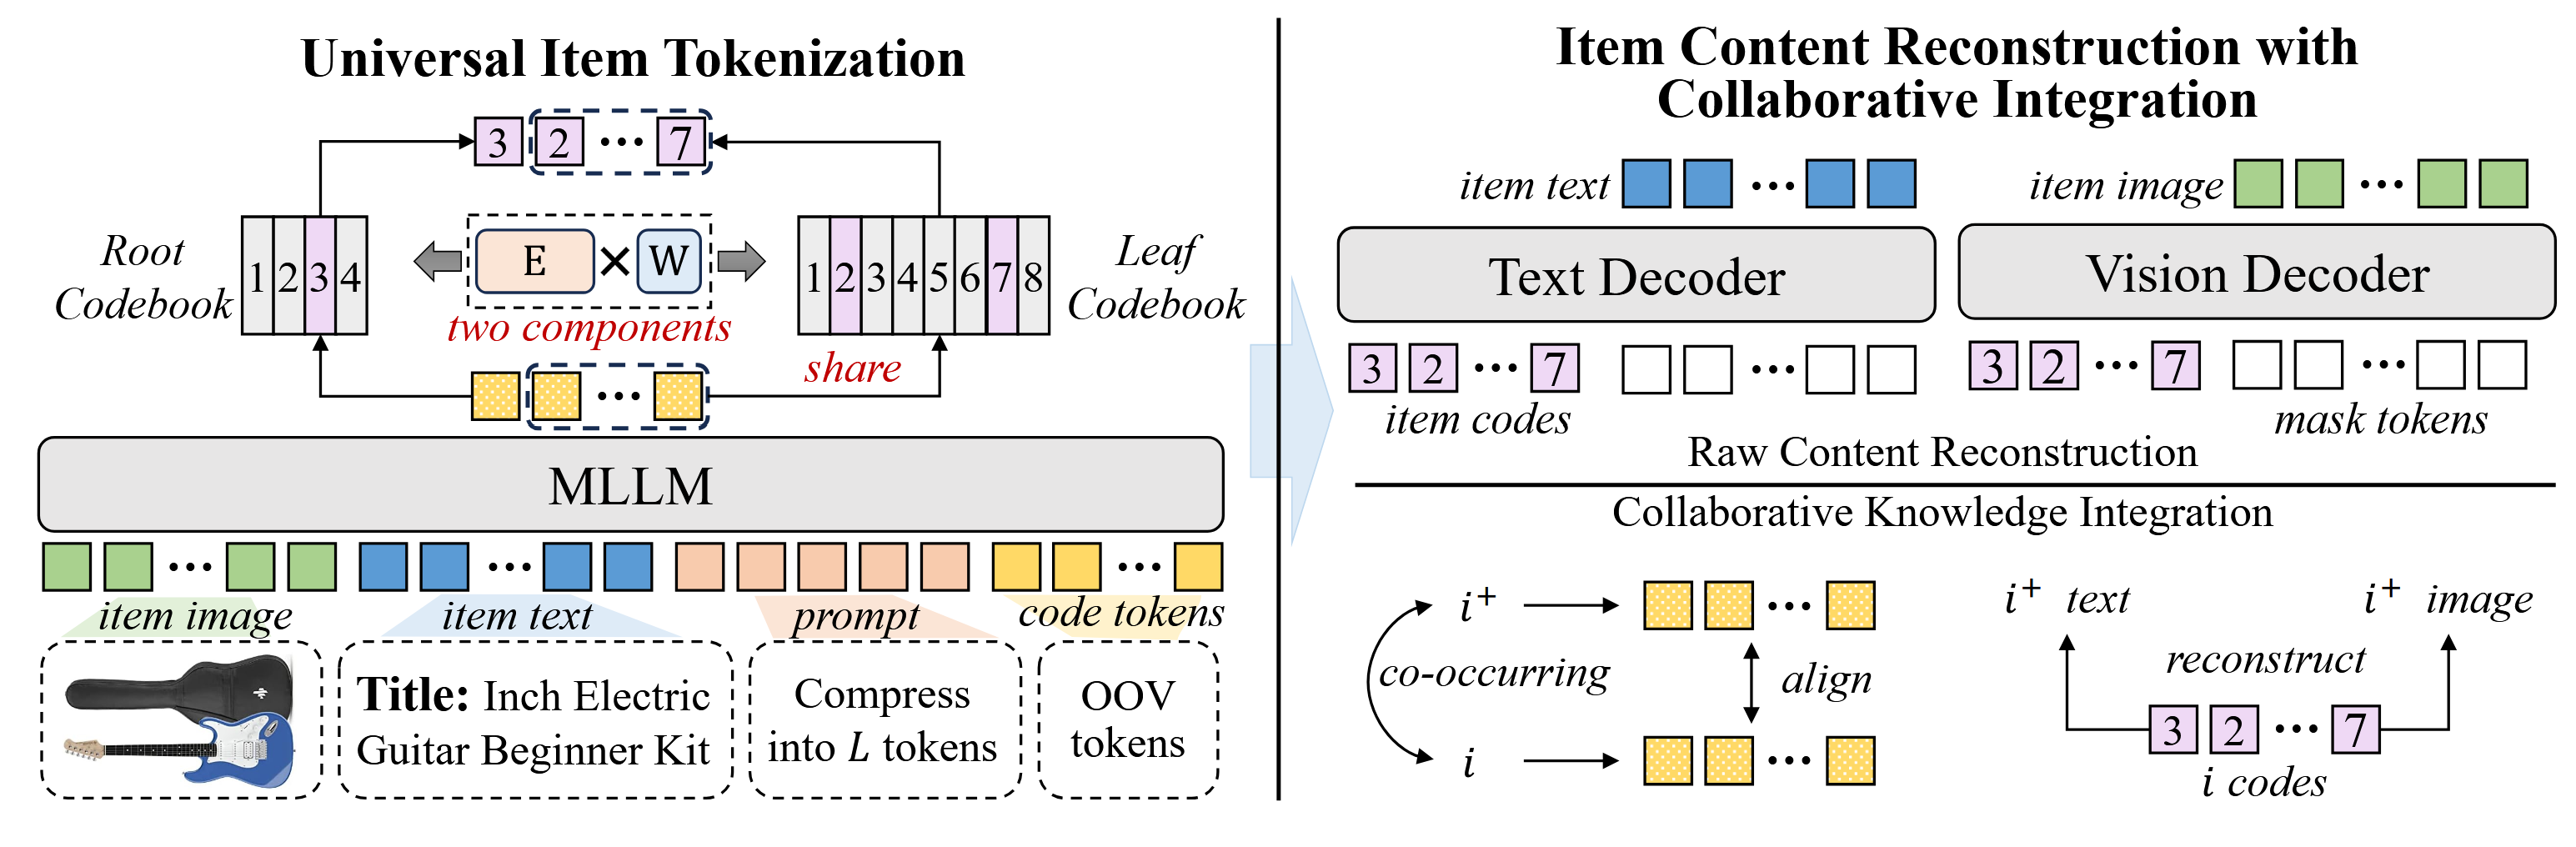
(Tokenizer Encoder: 多模态内容压缩) 编码器采用 Qwen2-VL-2B, 通过 LoRA 训练. 输入 item 图像、标题、属性和类别, 在提示末尾加入 $L$ 个可学习的特殊 token, 取其隐藏状态作为内容表示:
$$ \mathbf{H}=\operatorname{MLLM}(P(V_i,T_i)) \in \mathbb{R}^{L \times d}. $$这里 $P$ 为多模态提示, $d$ 为模型隐藏维度. 提示要求将内容压缩为由粗到细的 $L$ 个表示, 后续通过重建与协同目标训练这些表示.
-
(Prefix Residual: 提取相邻表示的增量) 同一 item 的多个隐藏状态可能过于相似, 导致不同位置重复编码相近内容. 作者先用 MLP 将其投影到码本维度, 再计算:
$$ \widetilde{\bm{h}}_1=\bm{h}'_1, \qquad \widetilde{\bm{h}}_l=\bm{h}'_l-\bm{h}'_{l-1}, \quad l=2,\ldots,L. $$第一项承载基本内容, 后续项表示相邻内容向量之间的变化. 这里减去的是前一位置的连续表示, 与 RQ-VAE 逐步减去已选码向量的残差量化不同.
-
(Tree-Structured Codebooks: 根码本与共享叶码本) 基本表示使用根码本, 所有增量表示共用叶码本:
$$ c_1=\arg\min_j\|\widetilde{\bm{h}}_1-(\mathbf{E}_r\mathbf{W}_r)_j\|_2^2, \qquad c_l=\arg\min_j\|\widetilde{\bm{h}}_l-(\mathbf{E}_f\mathbf{W}_f)_j\|_2^2,\quad l > 1. $$实验根码本含 $256$ 个向量, 叶码本含 $512$ 个向量, 三个编码位置总共使用 $768$ 个可学习码向量. 其结构重点是第一位置独立、后续位置共享, 并未为每个编码前缀分别配置一套子码本.
每个码本写成 $\mathbf{E}\mathbf{W}$, 使选中码向量产生的梯度也能通过共享的 $\mathbf{W}$ 改变整个码本空间. 作者以此促进跨域联合更新、缓解码本塌缩. 训练采用码本拟合与 commitment 损失, commitment 权重为 $0.25$.
-
(Tokenizer Decoder: 重建原始内容) 先累加量化后的增量, 恢复各位置的离散内容表示:
$$ \widehat{\bm{h}}_1=(\mathbf{C}_r)_{c_1}, \qquad \widehat{\bm{h}}_l=\widehat{\bm{h}}_{l-1}+(\mathbf{C}_f)_{c_l}. $$经过线性维度适配后, 分别送入两个轻量 decoder:
- 文本 decoder: 单层双向 Transformer, 输入离散内容表示及覆盖全部文本位置的 mask token, 用交叉熵预测原始文本. 100% masking 使重建依赖离散表示.
- 图像 decoder: 单层 Transformer, 输入离散内容表示与视觉 mask token, 再结合小型扩散模型计算图像重建的 diffusion loss.
内容重建目标为 $\mathcal{L}_{\mathrm{Raw}}=\mathcal{L}_t+\alpha\mathcal{L}_v$, 其中 $\alpha$ 平衡文本与图像损失. 弱 decoder 的设计意图是让语义信息更多地由编码器和码本承载.
-
(协同知识: 连续表示对齐 + 离散表示交叉重建) 从用户交互序列中采样相邻 item 对 $(i,i^+)$, 引入两项训练任务:
- 共现对齐 $\mathcal{L}_{\mathrm{Ali}}$: 对两个 item 同一位置的连续表示使用 InfoNCE, 以 batch 内其他正样本 item 作为负例. 多域混合 batch 提供跨域负例.
- 共现重建 $\mathcal{L}_{\mathrm{Re}}$: 用 $i$ 的离散内容表示重建 $i^+$ 的文本和图像. 因为不同 item 可能共享码向量, 对离散表示直接使用对比负例可能造成冲突, 作者在这一层采用无需负例的重建目标.
Tokenizer 的总损失为:
$$ \mathcal{L}_T=\mathcal{L}_{\mathrm{Raw}}+\lambda\mathcal{L}_{\mathrm{Code}}+\mu\mathcal{L}_{\mathrm{Ali}}+\eta\mathcal{L}_{\mathrm{Re}}. $$$\mathcal{L}_{\mathrm{Code}}$ 为码本学习损失, $\lambda,\mu,\eta$ 为各项权重.
-
(推荐模型预训练与迁移) 将多个域的交互历史转换为统一编码序列, 训练 T5 自回归预测目标 ID:
$$ \mathcal{L}_R=-\sum_{l=1}^{L}\log P(c_l\mid X,c_1,\ldots,c_{l-1}). $$新域适配时, 在码本中固定 $\mathbf{E}_r,\mathbf{E}_f$, 更新 $\mathbf{W}_r,\mathbf{W}_f$, 以保留已有编码关系并调整码向量的表示空间; tokenizer 沿用原训练目标, 编码长度固定. 然后重新编码目标域交互数据, 微调预训练的 T5. 这里的参数固定规则针对码本部分.
关键洞察
-
(数据与协议) 在 Amazon 2023 的 Arts Crafts and Sewing、Baby Products、CDs and Vinyl、Cell Phones and Accessories、Software 五个域预训练, 预处理后包含约 $34.4$ 万 item 和 $861$ 万交互. 下游为 Instrument、Scientific、Game、Office 四个域. 采用 5-core、最长 $20$ 个 item 的历史、逐用户 leave-one-out 划分和 full-ranking 评价, 生成模型的 beam size 均为 $50$.
-
(推荐结果) 下表摘录 NDCG@10, 最佳基线分别为 LETTER、MISSRec、LETTER、LETTER:
下游域 最佳基线 UTGRec Instrument 0.0313 0.0334 Scientific 0.0237 0.0255 Game 0.0473 0.0491 Office 0.0243 0.0269 UTGRec 在四个域的 Recall@5/10 与 NDCG@5/10 均领先, 论文报告配对 t 检验 $p < 0.01$. 多模态 TIGER 基线仅在部分域优于文本 TIGER, 表明加入图像特征本身并不必然带来收益.
-
(迁移时需要适配, 也需要保留编码关系) Scientific 上, 完整模型 NDCG@10 为 $0.0255$; 不微调 tokenizer 降至 $0.0218$; 连同 $\mathbf{E}_r,\mathbf{E}_f$ 一起微调为 $0.0225$. 固定码本基础矩阵、适配投影矩阵在该实验中优于直接复用和放开全部码本参数.
-
(两部分预训练都有贡献) Scientific 上, 保留 tokenizer 预训练、但推荐模型从头训练时 NDCG@10 为 $0.0236$; 两者均不预训练时为 $0.0232$. 因而最终收益包含 tokenizer 与推荐模型的多域学习, 不完全来自编码方式.
-
(编码冲突处理) 当两个 item 得到相同 ID 时, 作者将最后一位改为第二近或更远的候选码向量, 在不增加编码长度的情况下区分 item.
-
(与 UniTok 的差异) UniTok 使用内容向量上的共享 MLP 与量化专家, tokenizer 训练不依赖交互; UTGRec 使用可适配的多模态大模型直接编码内容, 联合学习编码与量化, 并通过共现目标引入交互信号. UTGRec 的迁移流程同时包含 tokenizer 适配与推荐模型微调.
继往开来
-
将通用 tokenizer 的学习推进到原始内容层面. 编码器、量化空间和内容重建目标共同优化, 使离散 ID 的语义能够随任务调整, 同时借助共现信息表达用户行为关系.
-
迁移不仅要求表示有效, 还要求编码关系可延续. $\mathbf{E}\mathbf{W}$ 分解既服务于码本联合更新, 也提供了迁移时保留基础编码结构、调整表示空间的接口. 这一设计将 tokenizer 适配与已预训练的生成模型联系起来.